Essai · Essais
PISA 2025 Espagne : IA et distraction numérique, avec des données
J'ai analysé les microdonnées de PISA 2025 en Espagne : la distraction numérique en classe est associée à une note plus basse ; l'usage de chatbots d'IA ne suit pas de schéma simple.
PISA est une évaluation internationale de l’OCDE qui étudie dans quelle mesure les élèves de 15 ans peuvent appliquer connaissances et compétences en Lecture, Mathématiques et Sciences : tous les trois ans, l’OCDE évalue des élèves de 15 ans dans des dizaines de pays, et en plus de l’épreuve, leur soumet un questionnaire sur le climat de leur classe et leurs habitudes —parmi elles, à quelle fréquence ils perçoivent de la distraction par des ressources numériques dans leur cours de Sciences et à quelle fréquence ils utilisent des chatbots d’IA type ChatGPT pour des tâches scolaires—. L’édition 2025, dont les résultats ont été publiés en septembre 2026, est la première à interroger sur l’usage de ces chatbots.
Tous les quelques mois circule un chiffre qui prétend clore le débat sur l’IA en classe : que l’utiliser « bien » équivaudrait à gagner une année scolaire entière. Je l’ai vue citée sans la source exacte plus de fois que je ne peux compter. Avant de la répéter, j’ai voulu vérifier ce que disent les microdonnées, pas le titre. J’ai donc téléchargé les réponses individuelles et anonymes des 29 966 enregistrements espagnols du PUF que j’ai analysés. Tout le processus est reproductible par quiconque dispose de la donnée originale et du cahier que je lie à la fin de l’article.
Ceci n’est pas un article sur un outil tiers, comme les audits techniques que j’ai déjà faits dans ce cahier avec openDAW ou RACK-02. C’est la même attitude —ouvrir la boîte, vérifier de mes propres mains au lieu de me fier au résumé de quelqu’un d’autre— appliquée à un jeu de données scientifique public plutôt qu’à un produit logiciel.
Pourquoi analyser les microdonnées, pas seulement le rapport
L’OCDE publie ses propres rapports PISA, avec des graphiques et des conclusions déjà élaborées. Les rapports officiels répondent à des questions précises au moyen de décisions analytiques déjà définies ; travailler en plus avec les microdonnées permet de formuler d’autres questions et de reproduire l’analyse. PISA publie aussi ces microdonnées : la réponse de chaque élève, sans identifier personne, déjà préparée, codée et documentée par l’OCDE elle-même —pas un export brut— dans un fichier appelé Public Use File (PUF) que n’importe qui peut télécharger et analyser de son côté. C’est ce que j’ai fait, avec le fichier élèves que l’OCDE elle-même héberge dans sa base de données PISA (téléchargement direct du fichier exact que j’ai utilisé, format SPSS, ~1 Go). PISA a sa propre fiche dans ce cahier, sur /concepto/pisa.
Travailler avec la donnée originale permet deux choses qu’un rapport déjà fait ne donne pas : choisir exactement quoi comparer (dans ce cas, l’usage de chatbots d’IA pour des tâches scolaires et la distraction perçue par des ressources numériques en classe, face à la note en Sciences) et vérifier par moi-même des affirmations qui circulent sur PISA avant de les répéter sans plus.
Une curiosité du processus de téléchargement lui-même, par honnêteté avec
la donnée : l’URL contient /pisa2022/, bien que le fichier corresponde
au cycle 2025. J’ai confirmé que le contenu est bien celui de l’édition
2025 en regardant à l’intérieur du fichier lui-même : il porte une marque
interne indiquant « 2025 », inclut des questions sur ChatGPT qui
n’existaient pas en 2022, et vient avec un bloc de données exclusif à
cette édition qui n’existe pas dans les précédentes.
Ce que j’ai comparé et comment
La question de départ est simple : parmi les élèves espagnols, ceux qui perçoivent plus de distraction par des ressources numériques dans leur classe obtiennent-ils une moins bonne note en Sciences ? Et ceux qui utilisent le plus des chatbots d’IA pour des tâches scolaires ? Et si la réponse est oui dans un cas, se maintient-elle si je tiens compte du fait que le niveau économique et culturel de la famille est déjà fortement associé à la performance, pour ne pas confondre l’un avec l’autre ?
Ce que j’ai utilisé du questionnaire, avec ses 29 966 réponses pour l’Espagne :
- À quelle fréquence les élèves perçoivent de la distraction par des ressources numériques dans leur cours de Sciences. L’item exact demande à quelle fréquence « les élèves se distraient en utilisant des ressources numériques (par exemple, téléphones, sites web, apps) » dans ce cours — c’est une question sur le climat général de la classe, pas une autoévaluation individuelle du type « je me distrais moi-même », et elle n’est pas limitée au téléphone : celui-ci n’est qu’un des exemples donnés entre parenthèses dans la question. Quatre réponses possibles, de « à chaque cours » à « jamais ou presque jamais ».
- À quelle fréquence ils utilisent des chatbots d’IA type ChatGPT, pour quatre tâches scolaires distinctes : résumer un texte, chercher de l’information sur un sujet, rédiger un travail, ou « m’aider à apprendre » en général — chacune avec sa propre fréquence, de « jamais » à « quotidiennement ». La question porte spécifiquement sur les chatbots conversationnels pour le travail scolaire (elle ne couvre pas d’autres types d’IA générative, comme les générateurs d’images) et n’est pas limitée à la classe : l’usage peut avoir lieu à la maison, en faisant des devoirs. J’analyse les finalités séparément parce qu’elles représentent des usages distincts et qu’il n’y a pas de raison de supposer qu’elles maintiennent la même relation avec la performance.
- La note en Sciences. Voici une nuance technique que je préfère raconter plutôt que cacher : PISA ne prétend pas estimer une note précise pour chaque élève. Pour les inférences sur la population, il fournit dix valeurs plausibles de performance ; l’analyse doit être répétée avec les dix, puis les résultats combinés.
- Le niveau économique et culturel de la famille (ESCS), pour pouvoir ajuster selon ce facteur et ne pas confondre « utilise beaucoup le chatbot » avec « vient d’une famille avec plus de ressources », ce qui est déjà en soi associé à une meilleure note. Cet indice combine trois éléments : le niveau d’études des parents, leur statut professionnel et les possessions/ressources du foyer.
- Le poids de chaque réponse. Tous les élèves ne comptent pas de la même manière dans le calcul : chacun porte un facteur de correction permettant d’estimer des résultats pour la population cible selon le plan d’échantillonnage de PISA, pas seulement pour qui a répondu à l’enquête.
Avec ces données, j’ai calculé la note moyenne en Sciences de chaque groupe (par exemple, « ceux qui utilisent le chatbot quotidiennement pour résumer des textes ») : j’ai calculé les moyennes pondérées et leurs intervalles de confiance à 95 %, en combinant les dix valeurs plausibles et les 80 réplications BRR-Fay, d’abord sans rien toucher d’autre puis en ajustant selon le niveau économico-culturel de la famille. Le script que j’ai écrit pour télécharger et analyser le fichier est public et n’importe qui peut reproduire le calcul exact sur le fichier officiel de l’OCDE.
Une réserve sur l’échantillon espagnol, à garder en tête en lisant tout ce qui suit : le taux d’exclusion d’élèves en Espagne dans cette édition était de 7,9 %, au-dessus du standard technique de 5 % établi par PISA, avec des hausses particulièrement marquées en Catalogne (de 5,6 % à 23,2 %) et en Murcie (de 4,1 % à 12,7 %). La fiche officielle de pays de l’OCDE elle-même (voir bibliographie) le signale sans détour : « Il est très probable que les niveaux élevés d’exclusions d’élèves entraînent un biais à la hausse. » Les données restent considérées comme comparables, mais il vaut la peine de lire les chiffres qui suivent avec cette nuance en tête.
Le résultat : deux schémas très différents
La distraction, elle, est un schéma clair : plus de distraction perçue, moins bonne note
Le score moyen estimé en Sciences diminue de façon monotone à mesure qu’augmente la fréquence de distraction par des ressources numériques que les élèves déclarent observer dans leur classe, sans aucune exception entre les quatre groupes. Dit plus directement : plus ils perçoivent de distraction, plus la note moyenne baisse.
- Perçoivent de la distraction à chaque cours — score moyen : 457,3 (461,5 ajusté selon l’ESCS)
- Ne la perçoivent jamais ou presque jamais — score moyen : 489,5 (491,0 ajusté selon l’ESCS)
Près de 32 points de différence entre le groupe qui perçoit le plus de distraction et celui qui en perçoit le moins, dans l’estimation brute. Ajuster selon le niveau économico-culturel de la famille réduit un peu la différence, mais ne la fait pas disparaître : le schéma se maintient tout aussi clair avec et sans cet ajustement. Une nuance honnête sur cet ajustement : l’échantillon ajusté exclut environ 1,4 % d’élèves sans donnée d’ESCS, si bien que la différence entre les courbes brute et ajustée combine l’ajustement statistique réel avec ce changement d’échantillon. Pour la distraction, en fait, l’essentiel de ce décalage vient d’exclure ces cas, pas de l’ajustement en lui-même — avec la nuance supplémentaire que ce que mesure cette question, c’est la perception des élèves sur le climat de leur classe, pas à quel point chaque élève se distrait individuellement.
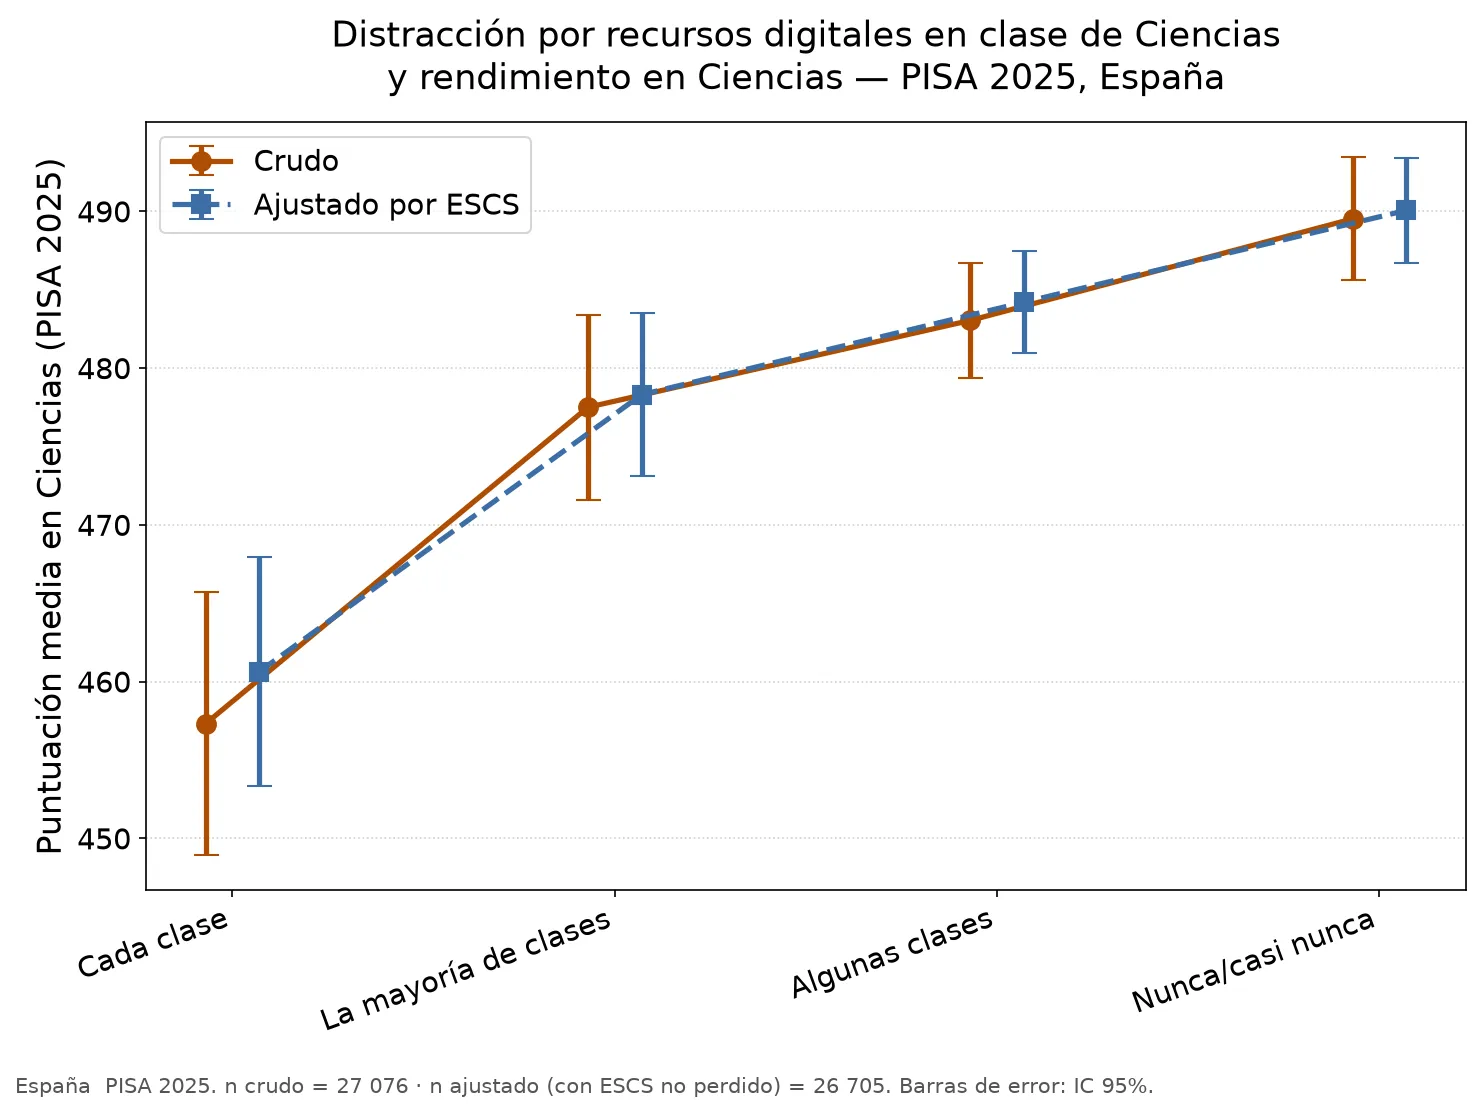
Distraction par des ressources numériques en cours de Sciences, perçue par les élèves : la relation est claire et constante, avec et sans ajustement selon le niveau économico-culturel de la famille. Moins de distraction perçue, meilleure note, sans exception.
Avec les chatbots d’IA, ce n’est pas pareil
C’est ici que le résultat s’écarte de ce que j’attendais moi-même en commençant. Pour les quatre tâches interrogées —résumer un texte, chercher de l’information, rédiger un travail, « m’aider à apprendre »— le score moyen ne change pas de façon monotone à mesure qu’augmente la fréquence d’usage du chatbot. La relation n’est monotone pour aucune des quatre, mais il n’y a pas non plus une forme unique qui les unifierait : chaque tâche dessine sa propre courbe, ce qui justifie de les regarder une à une. (Des intervalles de confiance qui se chevauchent entre groupes n’équivalent pas à un contraste de significativité, et tout ce qui suit est descriptif, pas causal — je développe les deux nuances dans le bloc de limitations plus bas.)
Résumer un texte. Ceux qui n’utilisent jamais ou presque jamais le chatbot pour cela présentent, des cinq groupes, la moyenne estimée la plus haute (497,3 points en brut, 501,2 ajusté). À partir de là, la note baisse avec l’usage occasionnel (« 1-2 fois par an », 476,5), remonte avec un usage plus habituel (mensuel, 488,1, et hebdomadaire, 481,6) sans atteindre le niveau de « jamais », et retombe à son point le plus bas avec l’usage quotidien (470,5). Ce n’est pas une baisse simple à mesure que l’usage du chatbot augmente : c’est « jamais » tout en haut, un creux dans l’usage occasionnel, une remontée partielle dans l’usage mensuel/ hebdomadaire, et le minimum dans l’usage quotidien.
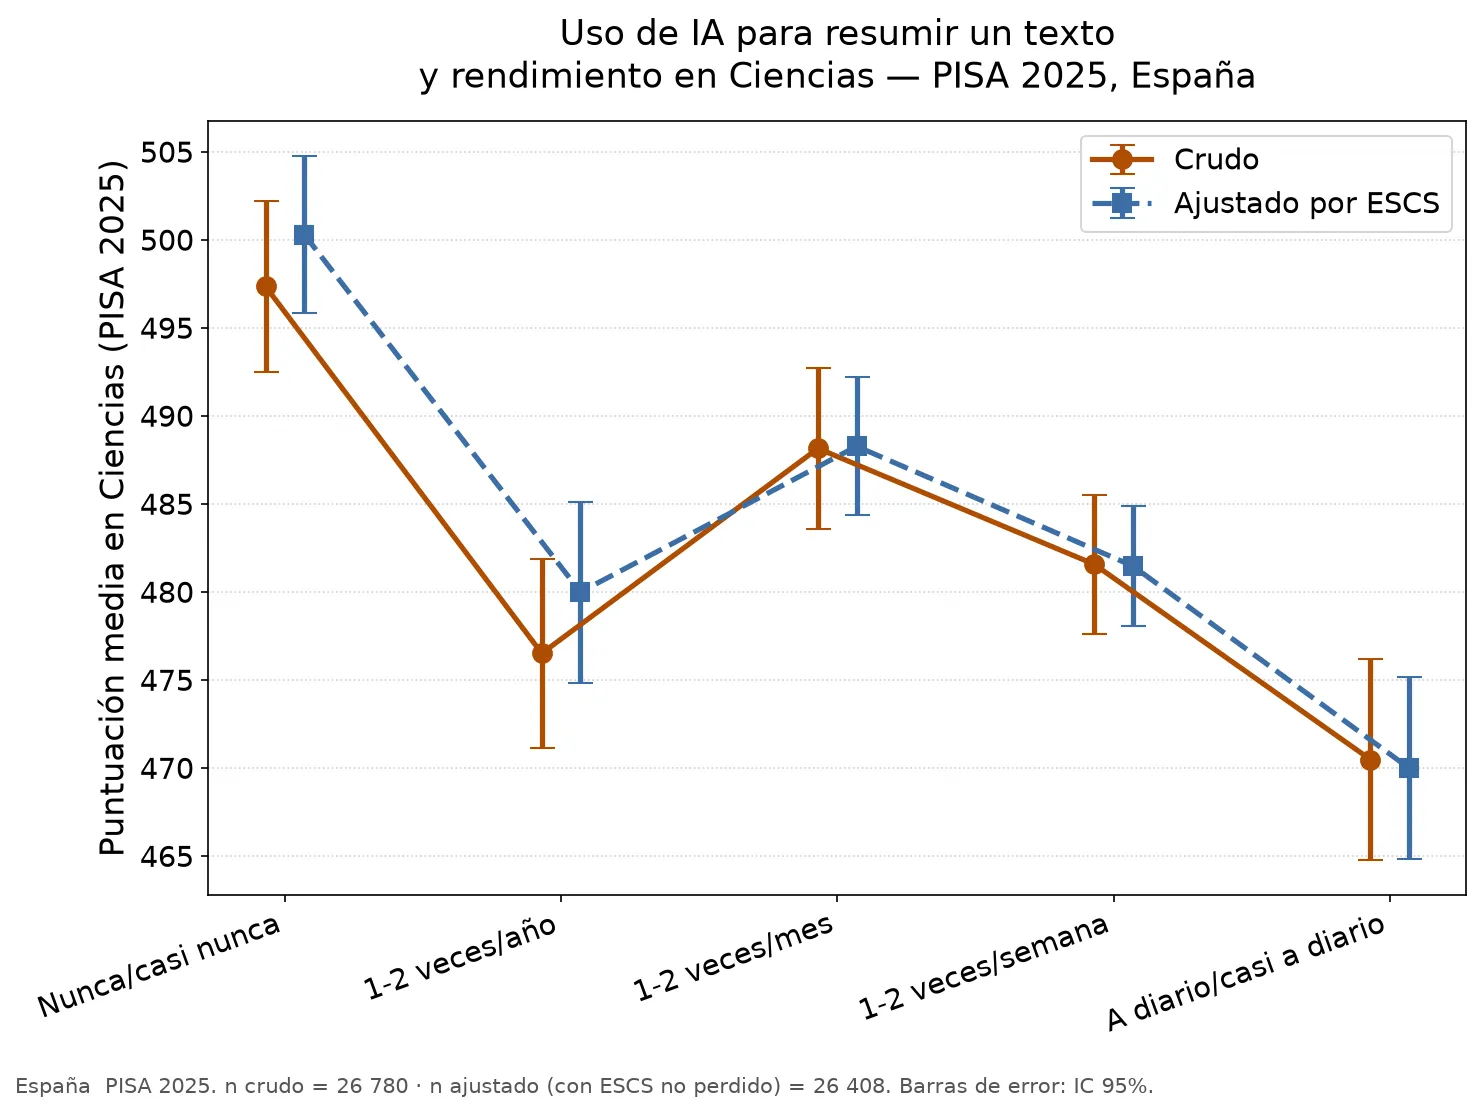
Usage du chatbot pour résumer un texte : la moyenne estimée la plus haute se trouve chez ceux qui ne l’utilisent jamais ou presque jamais pour cela ; la plus basse, chez ceux qui l’utilisent quotidiennement. Entre les deux extrêmes, la relation n’est pas monotone.
Chercher de l’information sur un sujet. Ici, la moyenne estimée la plus haute n’appartient pas à ceux qui n’utilisent jamais le chatbot, mais à ceux qui l’utilisent une ou deux fois par semaine — ce groupe présente, en moyenne, un score supérieur à celui de ceux qui ne l’utilisent jamais. La moyenne estimée la plus basse, en revanche, se trouve dans l’usage occasionnel (« 1-2 fois par an ») ; avec l’usage quotidien, la note baisse par rapport au pic hebdomadaire, sans pour autant être aussi basse que celle de l’usage occasionnel.
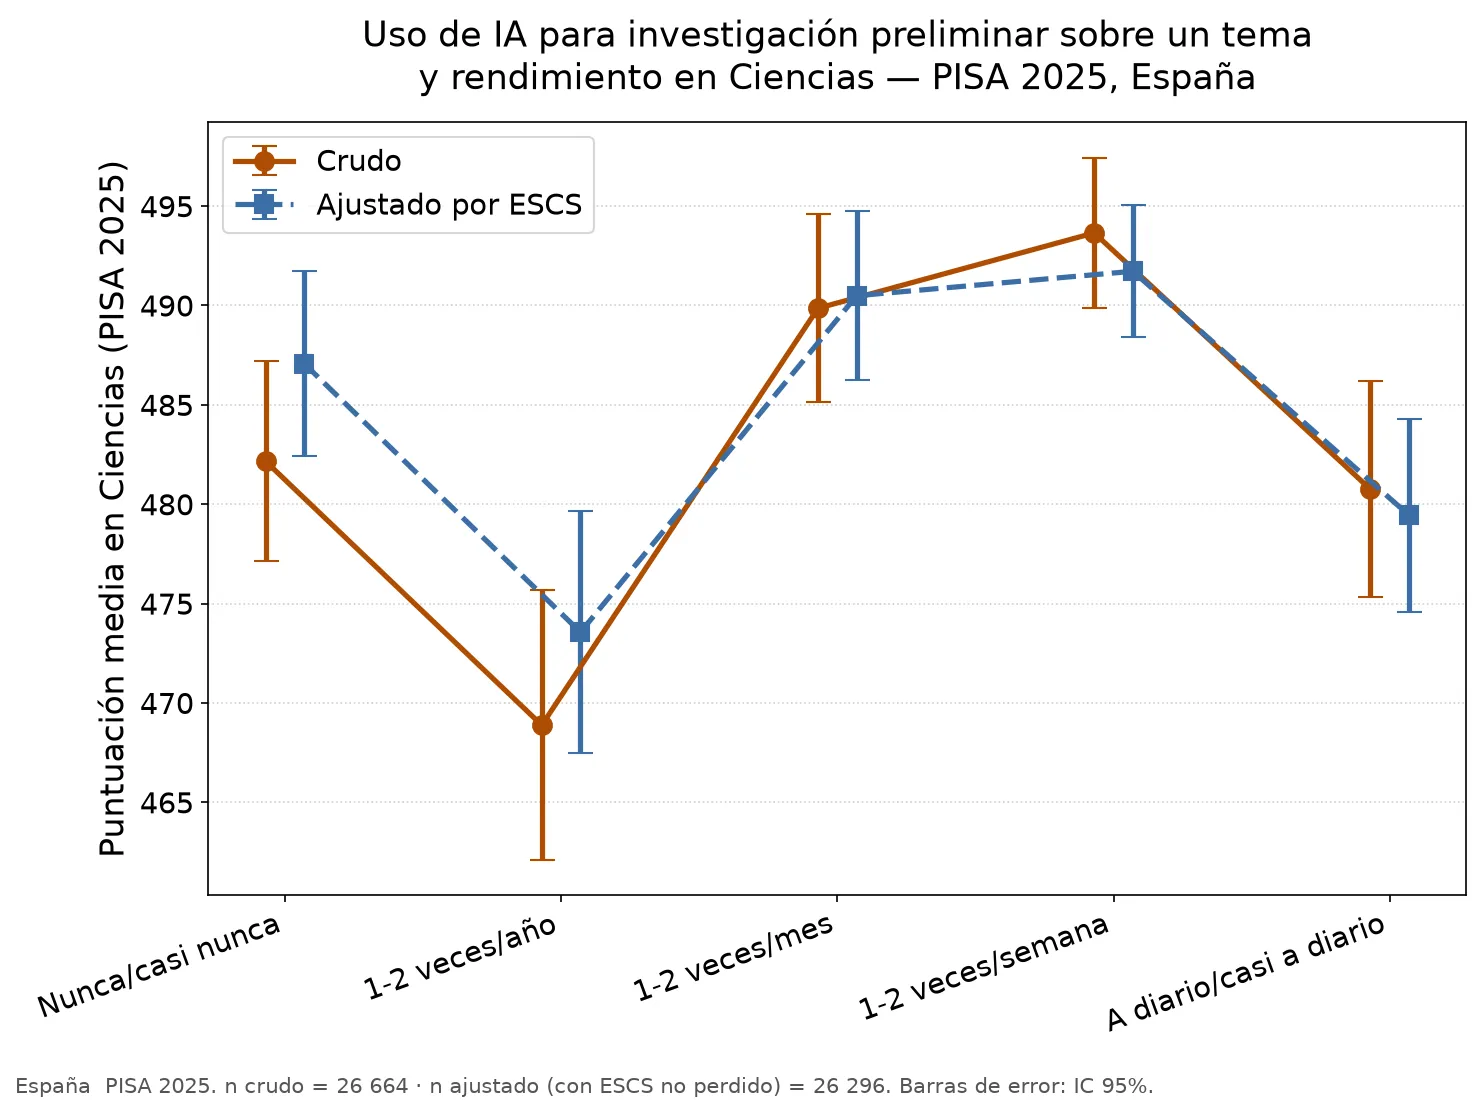
Usage du chatbot pour chercher de l’information : la moyenne estimée la plus haute se trouve chez ceux qui l’utilisent une ou deux fois par semaine, au-dessus même de ceux qui ne l’utilisent jamais pour cela ; la plus basse, dans l’usage très occasionnel.
Rédiger un travail. Des quatre, c’est la tâche à la courbe la plus simple : la note baisse déjà dès « jamais » et se maintient relativement stable, avec de petites oscillations, entre l’usage occasionnel et l’usage hebdomadaire, sans pic clair au-dessus de « jamais ». L’usage quotidien présente la note moyenne la plus basse des cinq groupes, bien que ses intervalles de confiance se chevauchent visuellement avec ceux de « 1-2 fois/semaine » et « 1-2 fois/mois » (voir les limitations sur ce qu’implique ce chevauchement).
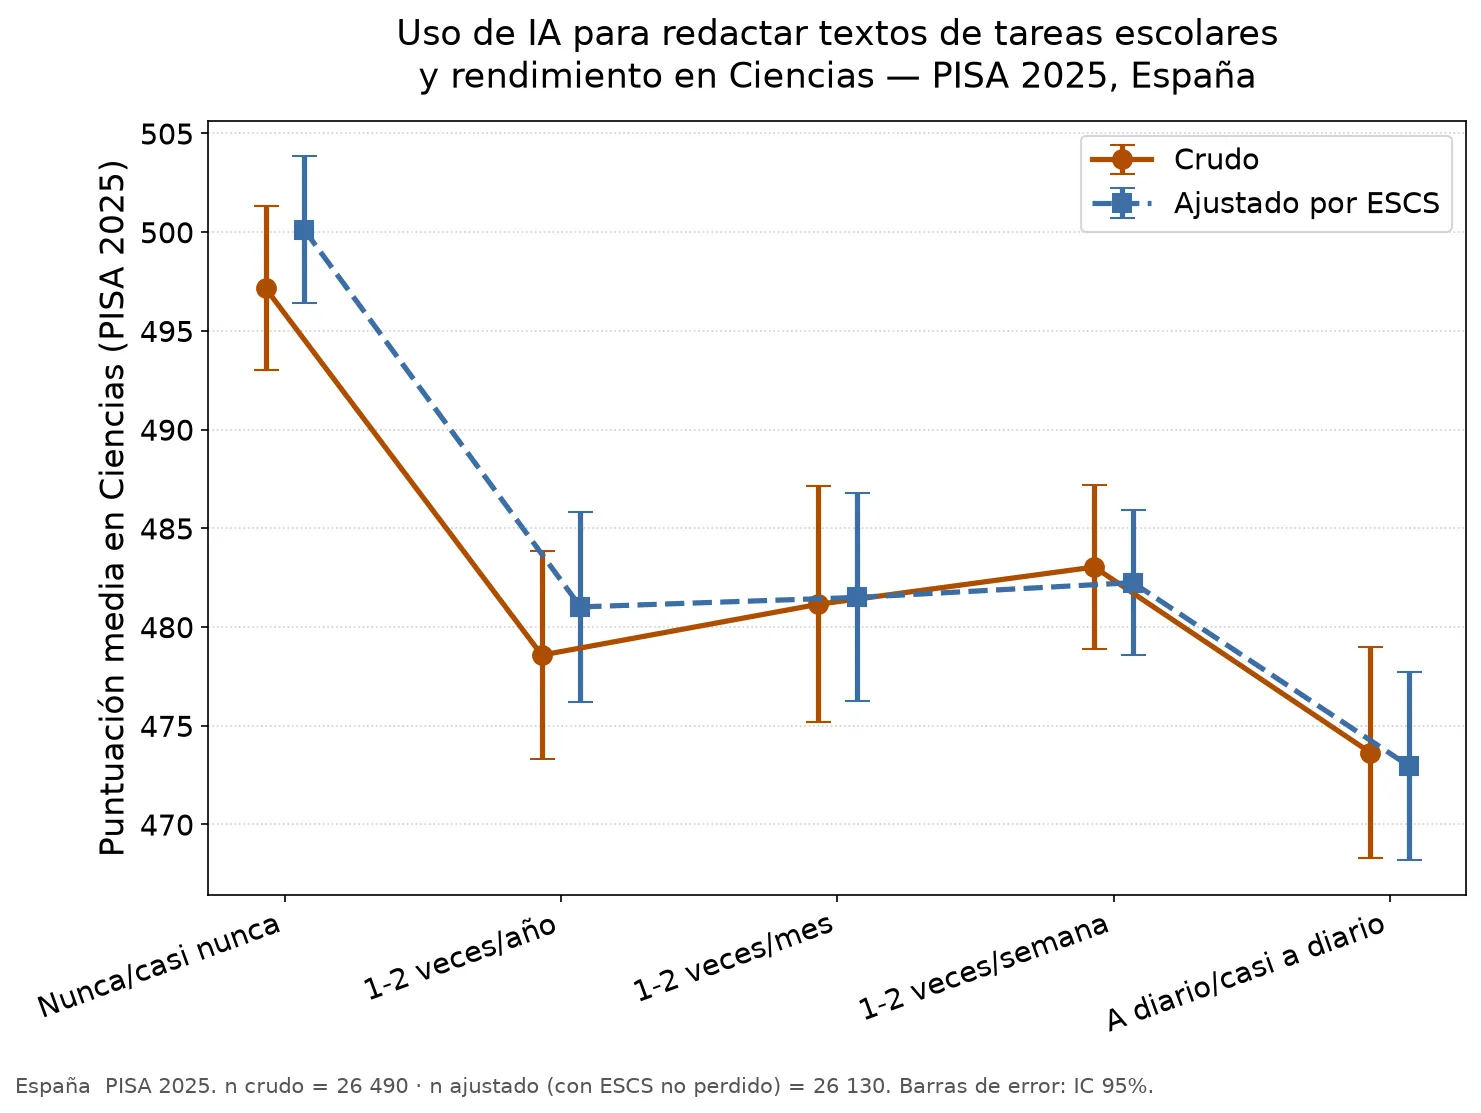
Usage du chatbot pour rédiger des travaux : la note moyenne la plus basse se trouve dans l’usage quotidien ; ses intervalles de confiance se chevauchent visuellement avec ceux de l’usage hebdomadaire et mensuel, et cette analyse ne calcule pas de contraste direct de cette différence.
Usage du chatbot pour « m’aider à apprendre ». Cet item demande seulement à quelle fréquence le chatbot est utilisé dans ce but déclaré — il ne demande rien sur l’accompagnement du corps enseignant ni sur un quelconque type de réflexion, donc je le traite pour ce qu’il est : une fréquence d’usage de plus, pas une mesure d’usage « accompagné » ou « réfléchi ». Il ne suit pas non plus de ligne claire : la note la plus basse se trouve dans l’usage très occasionnel et la plus haute dans l’usage hebdomadaire, et l’usage quotidien baisse un peu par rapport à l’hebdomadaire. La différence entre « jamais » et l’usage occasionnel, elle, a des intervalles de confiance qui se chevauchent visuellement (voir limitations).
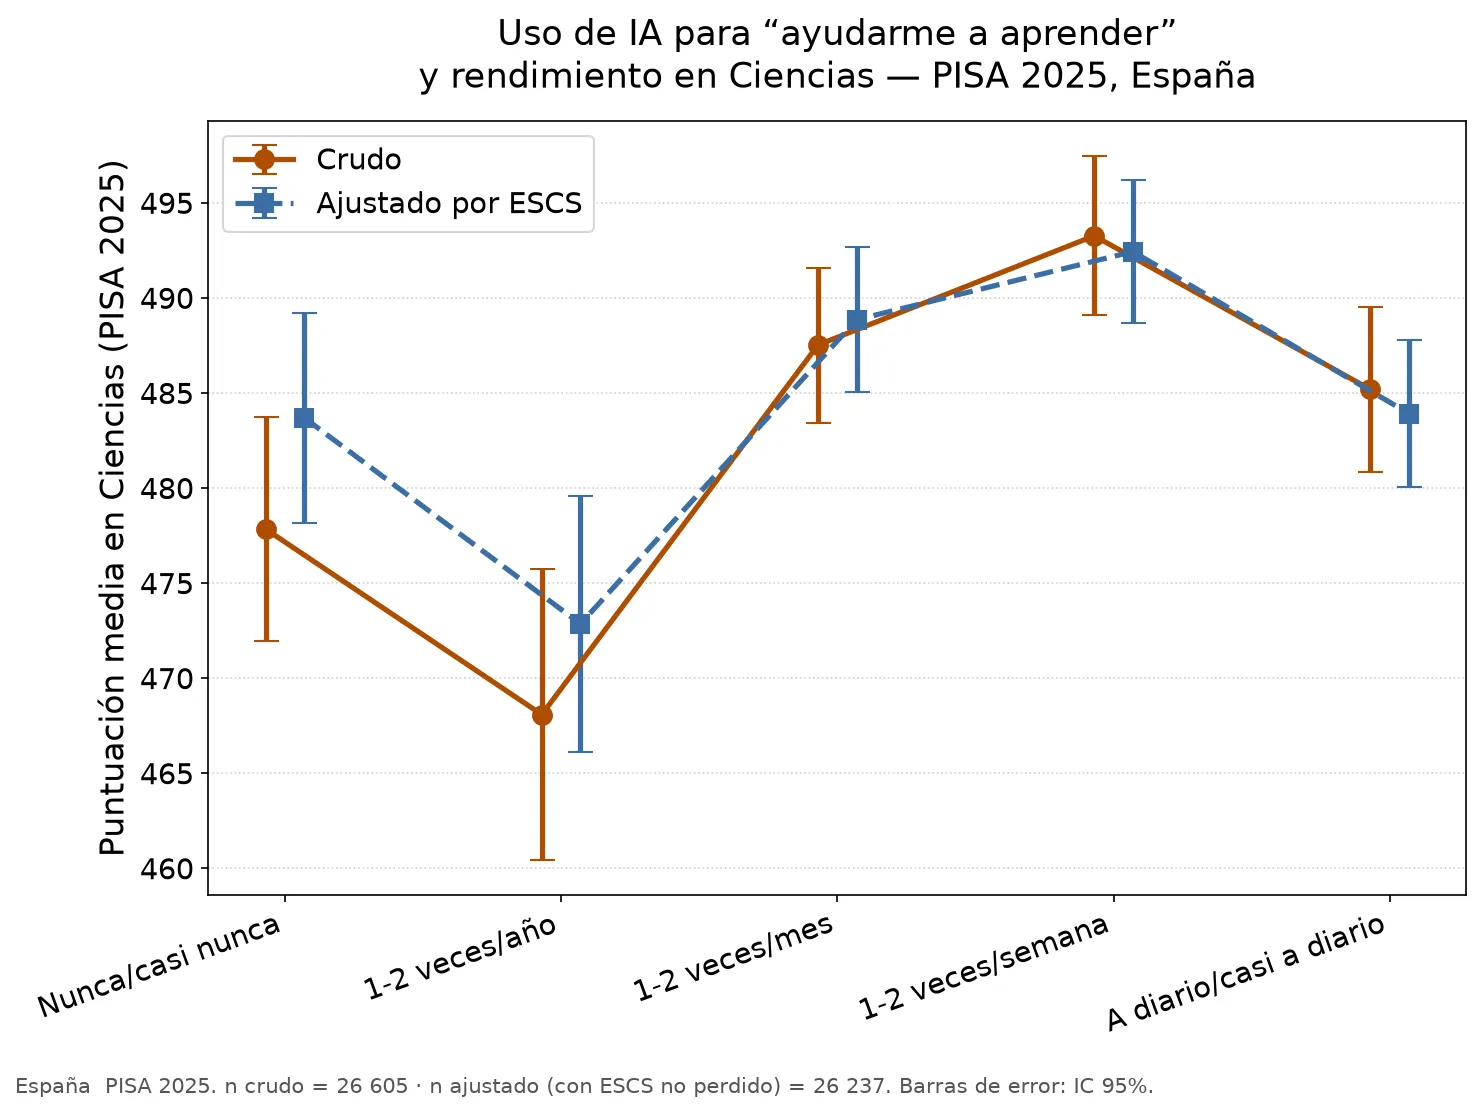
Usage du chatbot pour « m’aider à apprendre » : cette tâche non plus ne suit pas de ligne claire ; le pic se situe dans l’usage hebdomadaire.
L’ajustement selon l’ESCS modifie les estimations, mais n’élimine le caractère non monotone des schémas dans aucune des quatre tâches ; par conséquent, ces différences ne s’expliquent pas uniquement par la variation socio-économique captée par cet indice. La même nuance sur l’échantillon ajusté s’applique ici aussi : pour l’usage de l’IA, l’effet d’exclure ce ~1,4 % sans donnée d’ESCS et l’effet de l’ajustement réel sont, en général, d’une magnitude similaire — sauf dans deux catégories d’usage très peu fréquent (« chercher de l’information » et « m’aider à apprendre »), où l’ajustement selon l’ESCS domine clairement sur l’effet de l’exclusion d’échantillon.
L’idée avec laquelle j’ai commencé, et que la donnée ne confirme pas
J’ai commencé cette analyse en m’attendant à ce que l’usage du chatbot montre une relation aussi claire que celle de la distraction : que l’utiliser pour laisser la machine faire le travail à sa place pénaliserait la note, et que l’utiliser avec plus de discernement la protégerait, dans une relation facile à dessiner comme une ligne. Ce n’est pas ce que je trouve. Et il y a quelque chose d’aussi important que je dois dire avec la même clarté : avec ce type de donnée, prise en un seul instant, je ne peux pas savoir ce qui est la cause et ce qui est la conséquence.
Plusieurs explications sont compatibles avec ces résultats, et ce dispositif ne permet pas de trancher entre elles. Par exemple :
- Il se pourrait qu’utiliser beaucoup le chatbot soit une conséquence du fait d’être déjà en difficulté en classe (l’élève qui a le plus de difficultés recourt davantage à l’outil), et non la cause d’une moins bonne note.
- Certains schémas d’usage pourraient être un marqueur d’habitudes d’étude, de compétence numérique ou de performance préalable, et non leur cause : celui qui sait déjà bien étudier pourrait utiliser le chatbot différemment de celui qui ne sait pas, sans que cela implique que ce schéma d’usage soit la cause de la note.
Avec une seule photo fixe —sans suivre les mêmes élèves dans le temps— je ne peux écarter aucune de ces explications. Ce que montrent les moyennes estimées, c’est un profil non monotone dont la forme dépend de la tâche ; ce dispositif ne permet pas d’expliquer pourquoi.
Sur le chiffre de « l’année scolaire complète »
Le chiffre qui ouvrait cet article —qu’utiliser le chatbot « bien » équivaudrait à gagner une année scolaire entière face à l’utiliser « mal »— circule attribué à l’OCDE, mais presque toujours sans préciser d’où il sort exactement. Cette fois, j’ai bien localisé la source concrète : le rapport officiel PISA 2025 Results, Volume I, publié par l’OCDE le 8 septembre 2026, documente ce benchmark d’environ 20 points ≈ 1 an d’apprentissage dans un encadré identifié comme « Box I.2.2 ».
Avec une précision importante qu’il ne faut pas négliger : ce Box I.2.2 est un benchmark général pour interpréter les changements de score dans le temps, entre cycles de PISA — pas quelque chose que le chapitre du rapport consacré spécifiquement à l’IA applique au résultat sur la fréquence d’usage des chatbots. La combinaison précise qui circule (« utiliser l’IA bien ou mal équivaut à une année scolaire ») est une conversion faite par une couverture secondaire de tiers, qui assemble deux parties distinctes du rapport — le benchmark général d’un côté, le résultat sur l’IA de l’autre —, pas quelque chose que l’OCDE affirme littéralement en ces termes dans son chapitre sur l’IA.
J’ai essayé de recalculer cette conversion moi-même avec le fichier public (Public Use File) et je n’ai pas pu : le benchmark des 20 points n’est pas une variable qui manquerait dans le PUF 2025, c’est une estimation indépendante que l’OCDE construit avec une méthodologie propre sur d’autres données et cycles, donc il n’y a aucun moyen de la reproduire à partir de ce fichier isolé. Le chiffre a désormais une source concrète et localisable, mais reste quelque chose que je n’ai pas vérifié de façon indépendante avec mes propres moyens —je laisse la référence exacte dans la bibliographie, avec cette réserve.
Limitations de cette analyse
Avant les conclusions, il convient de réunir ici l’ensemble des limitations du dispositif, plutôt que la note brève qui accompagne déjà chaque graphique. C’est une analyse transversale : une seule photographie dans le temps qui ne permet pas d’établir la causalité. Les deux variables proviennent de réponses déclarées par les élèves dans le questionnaire, pas de registres objectifs : l’usage de chatbots est autodéclaré, tandis que la distraction recueille la perception des élèves sur le climat de leur classe, pas une autoévaluation de leur propre distraction individuelle. L’ajustement selon l’ESCS réduit, sans l’éliminer, la possible confusion avec d’autres variables non mesurées ici. Plusieurs des comparaisons entre catégories d’usage (par exemple, quand les intervalles de confiance se chevauchent) sont descriptives, sans contraste statistique direct entre groupes. Et les résultats concernent spécifiquement des élèves de 15 ans en Espagne et leur performance en Sciences — ils ne sont pas généralisables sans plus à d’autres âges, pays ou matières.
Ce que je retiens de cette analyse
Deux conclusions, ni l’une ni l’autre confortable comme titre facile :
- La distraction par des ressources numériques perçue en cours de Sciences est associée à une note plus basse de façon claire et constante, avec et sans ajustement selon le niveau économico-culturel de la famille. Cela ne surprend pas, mais je peux maintenant le dire après avoir vérifié la donnée moi-même, pas en répétant ce que dit quelqu’un d’autre.
- L’usage de chatbots d’IA dans les tâches scolaires ne suit aucun schéma simple — ni « plus tu les utilises, pire c’est » ni « utilise-les avec discernement et tu auras une meilleure note » ne tiennent comme règles simples. Les moyennes estimées montrent un profil non monotone, dont la forme change selon la tâche. Un dispositif longitudinal permettrait de mieux étudier la séquence temporelle ; pour estimer des effets causaux avec plus de solidité, des dispositifs expérimentaux ou quasi-expérimentaux seraient nécessaires.
Je continue à travailler avec des données ouvertes parce que je préfère me tromper avec transparence —en montrant exactement ce que j’ai comparé et comment— plutôt que de répéter un chiffre de quelqu’un d’autre que je n’ai pas pu vérifier.
Reproduis l’analyse toi-même
Les calculs empiriques de cette analyse —les moyennes, les intervalles de confiance, les graphiques— peuvent être reproduits de façon indépendante avec la donnée et le cahier ci-dessous, sans avoir à me faire confiance sur parole. Deux choses restent à ta disposition :
La donnée originale. Le fichier que j’ai analysé est le Student Questionnaire Data File de PISA 2025, publié par l’OCDE elle-même :
- Page officielle de la base de données PISA à l’OCDE (l’OCDE continue d’y héberger le cycle 2025, avec la curiosité de l’URL que je raconte plus haut).
- Téléchargement direct du fichier exact que j’ai utilisé (format SPSS, ~1 Go, réponses anonymes de plus de 755 000 élèves de 91 pays, dont les 29 966 enregistrements espagnols que j’utilise ici).
Le cahier avec tout le processus. J’ai publié un cahier Jupyter téléchargeable avec l’analyse complète, du début à la fin : comment extraire le sous-ensemble espagnol du fichier de l’OCDE, comment j’ai vérifié que la donnée était bien celle du cycle 2025 et non d’une édition antérieure, la combinaison des dix valeurs plausibles de performance avec le poids d’échantillonnage et les réplications de rééchantillonnage (BRR-Fay), l’ajustement selon le niveau socio-économico-culturel —y compris la comparaison en trois étapes (brute avec tous les cas, brute restreinte à ceux ayant une donnée d’ESCS, et ajustée) qui me permet de séparer l’effet d’exclure ce ~1,4 % sans ESCS de l’effet réel de l’ajustement—, et le code qui génère les cinq graphiques de cet article. Il est pensé pour que n’importe qui —avec des connaissances de base en Python— puisse l’exécuter sur le même fichier et vérifier qu’il arrive exactement aux mêmes chiffres, ou pour l’adapter et vérifier d’autres questions sur le même jeu de données.
Deux analyses sœurs sur xiringase.com
Cette analyse fait partie d’une conversation plus large sur PISA 2025 et la technologie que je poursuis sur xiringase.com, la marque sœur de cet écosystème. Deux pièces complémentaires traitent le même jeu de données sous d’autres angles : PISA 2025 et la technologie en classe, sur les appareils et la distraction numérique en général, et PISA 2025 et l’IA : pourquoi la bonne question n’est pas quel chatbot tu utilises, mais comment tu l’utilises, qui reprend directement le résultat de cette analyse —l’absence de schéma simple selon le type de tâche— pour se demander ce que cela signifie pour le discernement avec lequel on utilise l’IA en classe.
Bibliographie
- OCDE. PISA 2025 Database. Organisation de coopération et de développement économiques.
- OCDE. PISA — Programme for International Student Assessment. Page officielle du programme.
- OCDE. PISA 2025 Results (Volume I). Publié le 8 septembre 2026. Source du benchmark d’environ 20 points ≈ 1 an d’apprentissage mentionné dans cet article, documenté dans l’encadré « Box I.2.2 » ; non recalculé avec le PUF 2025 car le benchmark provient d’une estimation indépendante fondée sur des informations de plusieurs cycles, pas d’une variable contenue dans ce fichier. Consulter le catalogue des publications de PISA 2025 sur oecd.org pour l’édition exacte.
- OCDE. PISA 2025 Results (Volume I) — Country Notes: Spain. Source du taux d’exclusion d’échantillon de l’Espagne (7,9 %), de la répartition par communauté autonome (Catalogne, Murcie) et de l’avertissement explicite de l’OCDE elle-même sur le possible biais à la hausse qu’introduit cette exclusion.
- OCDE. PISA 2025 Database — Student Questionnaire et Codebook & Compendia. Source de la formulation et du codage exact des items
ST097Q06DA(distraction par des ressources numériques) etST438Q01DA–ST438Q04DA(usage de chatbots d’IA) décrits dans cet article.