Ensayo · Ensayos
PISA 2025 España: IA y distracción digital, con datos
Analicé los microdatos de PISA 2025 en España: la distracción digital en clase se asocia con peor nota; el uso de chatbots de IA no sigue un patrón simple.
PISA es una evaluación internacional de la OCDE que estudia hasta qué punto el alumnado de 15 años puede aplicar conocimientos y competencias en Lectura, Matemáticas y Ciencias: cada tres años, la OCDE evalúa a estudiantes de 15 años de decenas de países, y junto al examen les pasa un cuestionario sobre el clima de su clase y sus hábitos —entre ellos, cuánta distracción por recursos digitales perciben en su clase de Ciencias y cuánto usan chatbots de IA tipo ChatGPT para tareas escolares—. La edición 2025, con resultados publicados en septiembre de 2026, es la primera que pregunta por el uso de estos chatbots.
Cada pocos meses circula una cifra que promete zanjar el debate sobre la IA en las aulas: que usarla “bien” equivale a ganar un año escolar entero. La he visto citada sin la fuente exacta más veces de las que puedo contar. Antes de repetirla, quise comprobar qué dicen los microdatos, no el titular. Así que descargué las respuestas individuales y anónimas de los 29.966 registros españoles del PUF que analicé. Todo el proceso es repetible por cualquiera con el dato original y el cuaderno que enlazo al final del artículo.
Esto no es una pieza sobre una herramienta de terceros, como las auditorías técnicas que ya he hecho en este cuaderno con openDAW o RACK-02. Es la misma actitud —abrir la caja, verificar con mis propias manos en vez de fiarme del resumen de otro— aplicada a un dataset científico público en vez de a un producto de software.
Por qué analizar los microdatos, no solo el informe
La OCDE publica sus propios informes de PISA, con gráficos y conclusiones ya elaboradas. Los informes oficiales responden preguntas concretas mediante decisiones analíticas ya definidas; trabajar además con los microdatos permite formular otras preguntas y reproducir el análisis. PISA también publica esos microdatos: la respuesta de cada estudiante, sin identificar a nadie, ya preparada, codificada y documentada por la propia OCDE —no un volcado sin procesar— en un fichero llamado Public Use File (PUF) que cualquiera puede descargar y analizar por su cuenta. Eso hice, con el fichero de estudiantes que la propia OCDE aloja en su base de datos de PISA (descarga directa del fichero exacto que usé, formato SPSS, ~1 GB). PISA tiene ficha propia en este cuaderno, en /concepto/pisa.
Trabajar con el dato original permite dos cosas que un informe ya hecho no da: elegir exactamente qué comparar (en este caso, uso de chatbots de IA en tareas escolares y distracción percibida por recursos digitales en clase, frente a la nota en Ciencias) y comprobar por mi cuenta afirmaciones que circulan sobre PISA antes de repetirlas sin más.
Una curiosidad del propio proceso de descarga, por honestidad con el dato:
la URL contiene /pisa2022/, aunque el fichero corresponde al ciclo 2025.
Confirmé que el contenido es realmente de la edición
2025 mirando dentro del propio fichero: trae una marca interna que dice
“2025”, incluye preguntas sobre ChatGPT que no existían en 2022, y viene con
un bloque de datos exclusivo de esta edición que no existe en las
anteriores.
Qué comparé y cómo
La pregunta de partida es sencilla: entre el alumnado español, ¿sacan peor nota en Ciencias quienes perciben más distracción por recursos digitales en su clase? ¿Y quienes más usan chatbots de IA para tareas escolares? Y si la respuesta es sí en algún caso, ¿se mantiene si tengo en cuenta que el nivel económico y cultural de la familia ya está fuertemente asociado con el rendimiento, para no confundir una cosa con la otra?
Lo que usé del cuestionario, con sus 29.966 respuestas de España:
- Cuánta distracción por recursos digitales perciben en su clase de Ciencias. El ítem exacto pregunta con qué frecuencia “el alumnado se distrae usando recursos digitales (por ejemplo, móviles, páginas web, apps)” en esa clase — es una pregunta sobre el clima general del aula, no un autoinforme de “yo me distraigo”, y no está limitada al móvil: el móvil es solo uno de los ejemplos que da la pregunta entre paréntesis. Cuatro respuestas posibles, de “en cada clase” a “nunca o casi nunca”.
- Cuánto usan chatbots de IA tipo ChatGPT, para cuatro tareas escolares distintas: resumir un texto, buscar información sobre un tema, redactar un trabajo, o “ayudarme a aprender” en general — cada una con su propia frecuencia, de “nunca” a “a diario”. La pregunta es específica de chatbots conversacionales para trabajo escolar (no cubre otro tipo de IA generativa, como generadores de imagen) y no está limitada al aula: puede ser un uso en casa, haciendo deberes. Analizo las finalidades por separado porque representan usos distintos y no hay razón para asumir que mantengan la misma relación con el rendimiento.
- La nota en Ciencias. Aquí un matiz técnico que prefiero contar en vez de esconder: PISA no pretende estimar una nota precisa para cada estudiante. Para las inferencias sobre la población proporciona diez valores plausibles del rendimiento; el análisis debe repetirse con los diez y combinar después los resultados.
- El nivel económico y cultural de la familia (ESCS), para poder ajustar por él y no confundir “usa mucho el chatbot” con “viene de una familia con más recursos”, que ya de por sí se asocia con mejor nota. Este índice combina tres cosas: el nivel educativo de los progenitores, su estatus ocupacional y las posesiones/recursos del hogar.
- El peso de cada respuesta. No todos los estudiantes cuentan igual en el cálculo: cada uno lleva un factor de corrección para estimar resultados de la población objetivo de acuerdo con el diseño muestral de PISA, no solo a quien contestó la encuesta.
Con esos datos calculé la nota media en Ciencias de cada grupo (por ejemplo, “quienes usan el chatbot a diario para resumir textos”): calculé las medias ponderadas y sus intervalos de confianza al 95%, combinando los diez valores plausibles y las 80 réplicas BRR-Fay, primero sin tocar nada más y después ajustando por el nivel económico-cultural de la familia. El script que hice para descargar y analizar el fichero es público y cualquiera puede repetir el cálculo exacto sobre el fichero oficial de la OCDE.
Una salvedad sobre la muestra española, que conviene tener presente al leer todo lo que sigue: la tasa de exclusión de estudiantes en España en esta edición fue del 7,9%, por encima del estándar técnico del 5% establecido por PISA, con aumentos especialmente marcados en Cataluña (del 5,6% al 23,2%) y Murcia (del 4,1% al 12,7%). La propia ficha oficial de país de la OCDE (ver bibliografía) lo advierte sin rodeos: “Es muy probable que los elevados niveles de exclusiones de estudiantes den lugar a un sesgo al alza.” Los datos siguen considerándose comparables, pero merece la pena leer las cifras que siguen con ese matiz en mente.
El resultado: dos patrones muy distintos
La distracción sí es un patrón claro: a más distracción percibida, peor nota
La puntuación media estimada en Ciencias disminuye de forma monotónica conforme aumenta la frecuencia de distracción por recursos digitales que el alumnado declara observar en su clase, sin ninguna excepción entre los cuatro grupos. Dicho de forma más directa: cuanta más distracción perciben, peor nota sacan de media.
- Perciben distracción en cada clase — puntuación media: 457.3 (461.5 ajustada por ESCS)
- Nunca o casi nunca la perciben — puntuación media: 489.5 (491.0 ajustada por ESCS)
Casi 32 puntos de diferencia entre el grupo que más distracción percibe y el que menos, en la estimación cruda. Ajustar por el nivel económico-cultural de la familia reduce un poco la diferencia, pero no la hace desaparecer: el patrón se mantiene igual de claro con y sin ese ajuste. Un matiz honesto sobre ese ajuste: la muestra ajustada excluye en torno al 1,4% de estudiantes sin dato de ESCS, así que la diferencia entre las curvas cruda y ajustada combina el ajuste estadístico real con ese cambio de muestra. Para la distracción, de hecho, la mayor parte de ese desplazamiento viene de excluir esos casos, no del ajuste en sí — con el matiz adicional de que lo que mide esta pregunta es la percepción del alumnado sobre el clima de su clase, no cuánto se distrae cada estudiante en particular.
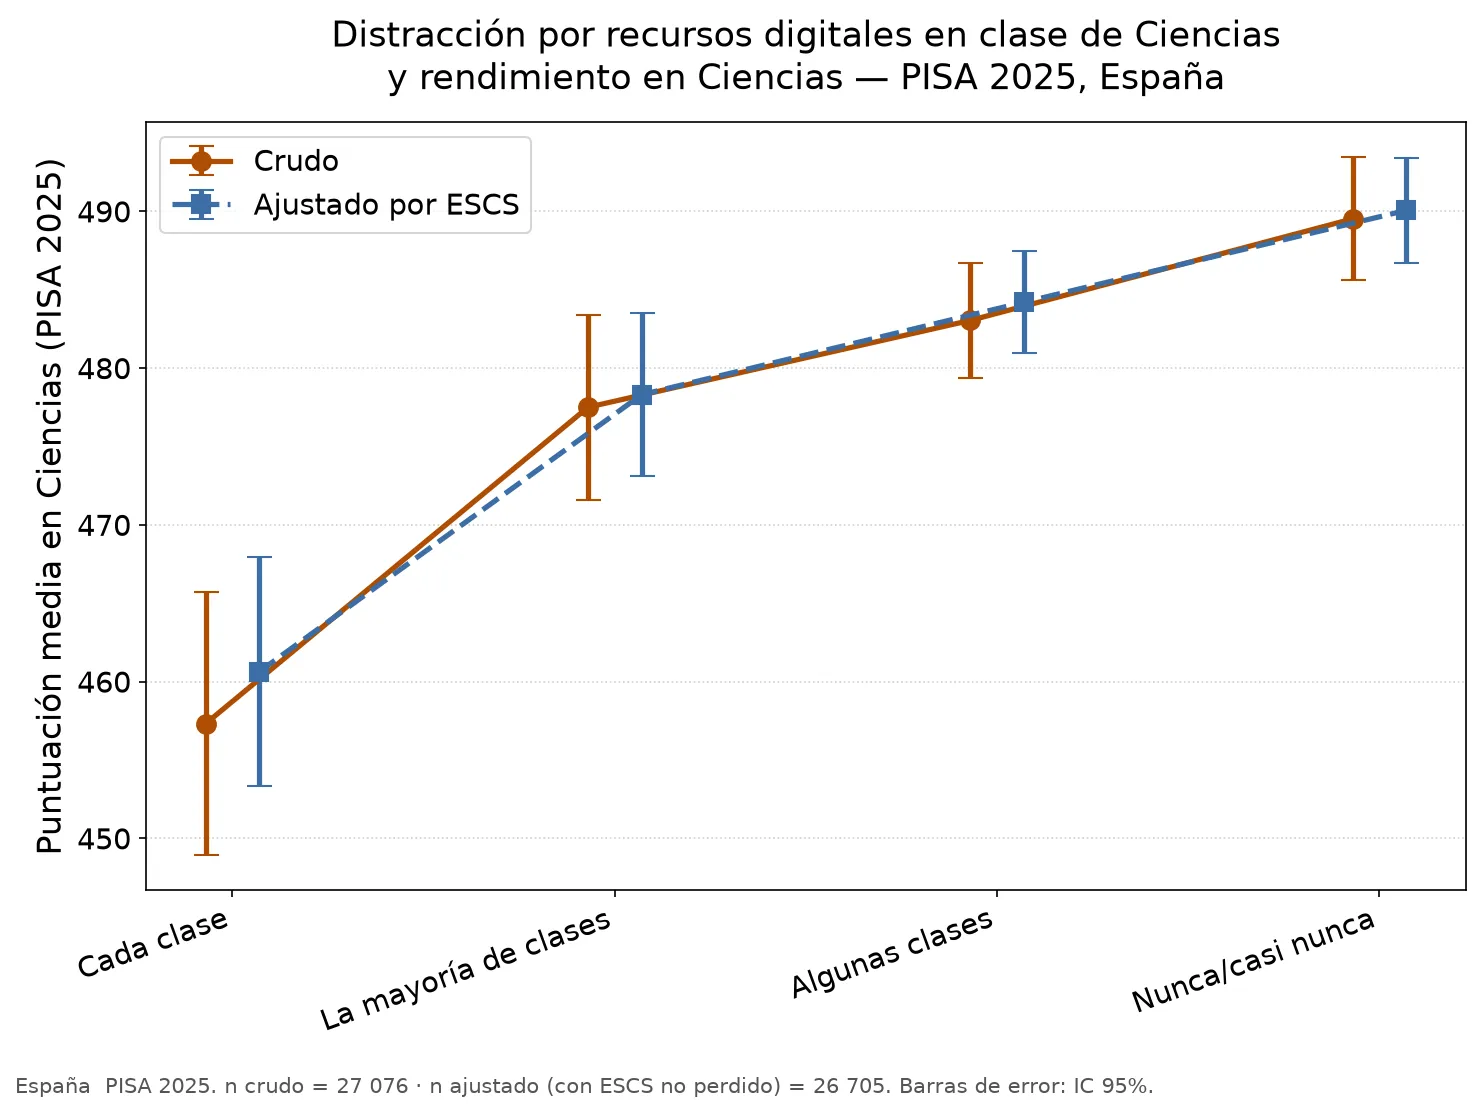
Distracción por recursos digitales en clase de Ciencias, percibida por el alumnado: la relación es clara y constante, con y sin ajustar por el nivel económico-cultural de la familia. A menos distracción percibida, mejor nota, sin excepciones.
Con los chatbots de IA no pasa lo mismo
Aquí es donde el resultado se aparta de lo que yo mismo esperaba al empezar. Para las cuatro tareas que pregunté —resumir un texto, buscar información, redactar un trabajo, “ayudarme a aprender”— la puntuación media no cambia de forma monotónica conforme aumenta la frecuencia de uso del chatbot. La relación no es monotónica en ninguna de las cuatro, pero tampoco hay una única forma que las unifique: cada tarea dibuja su propia curva, así que merece la pena verlas una a una. (Los intervalos de confianza solapados entre grupos no equivalen a un contraste de significación, y todo lo que sigue es descriptivo, no causal — desarrollo ambos matices en el bloque de limitaciones más abajo.)
Resumir un texto. Quien nunca o casi nunca usa el chatbot para esto presenta, de los cinco grupos, la media estimada más alta (497,3 puntos en crudo, 501,2 ajustada). Desde ahí, la nota baja con el uso ocasional (“1-2 veces al año”, 476,5), repunta con un uso más habitual (mensual, 488,1, y semanal, 481,6) sin llegar al nivel de “nunca”, y cae a su punto más bajo con el uso diario (470,5). No es una caída simple según se usa más el chatbot: es “nunca” arriba del todo, un bache en el uso ocasional, un repunte parcial en el uso mensual/semanal, y el mínimo en el uso diario.
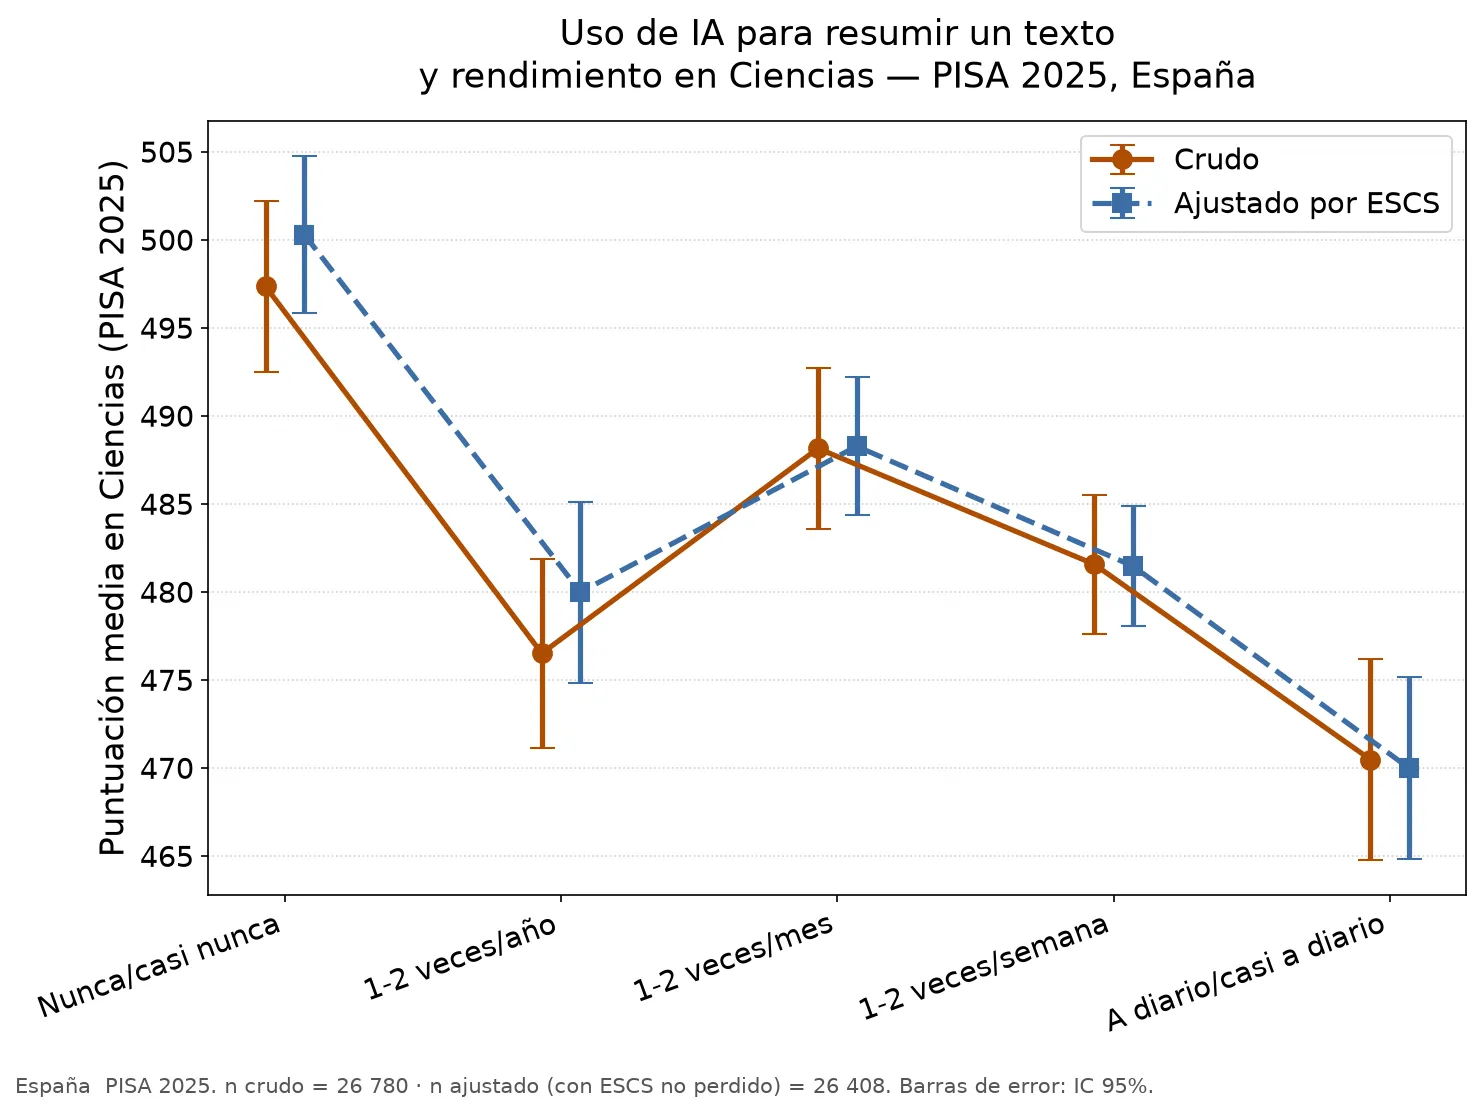
Uso del chatbot para resumir un texto: la media estimada más alta está en quien nunca o casi nunca lo usa para esto; la más baja, en quien lo usa a diario. Entre ambos extremos, la relación no es monótona.
Buscar información sobre un tema. Aquí la media estimada más alta no la tiene quien nunca usa el chatbot, sino quien lo usa una o dos veces por semana — ese grupo presenta, de media, una puntuación superior a la de quien no lo usa nunca. La media estimada más baja, en cambio, está en el uso ocasional (“1-2 veces al año”); con el uso diario la nota baja respecto al pico semanal, aunque sin llegar a ser tan baja como la del uso ocasional.
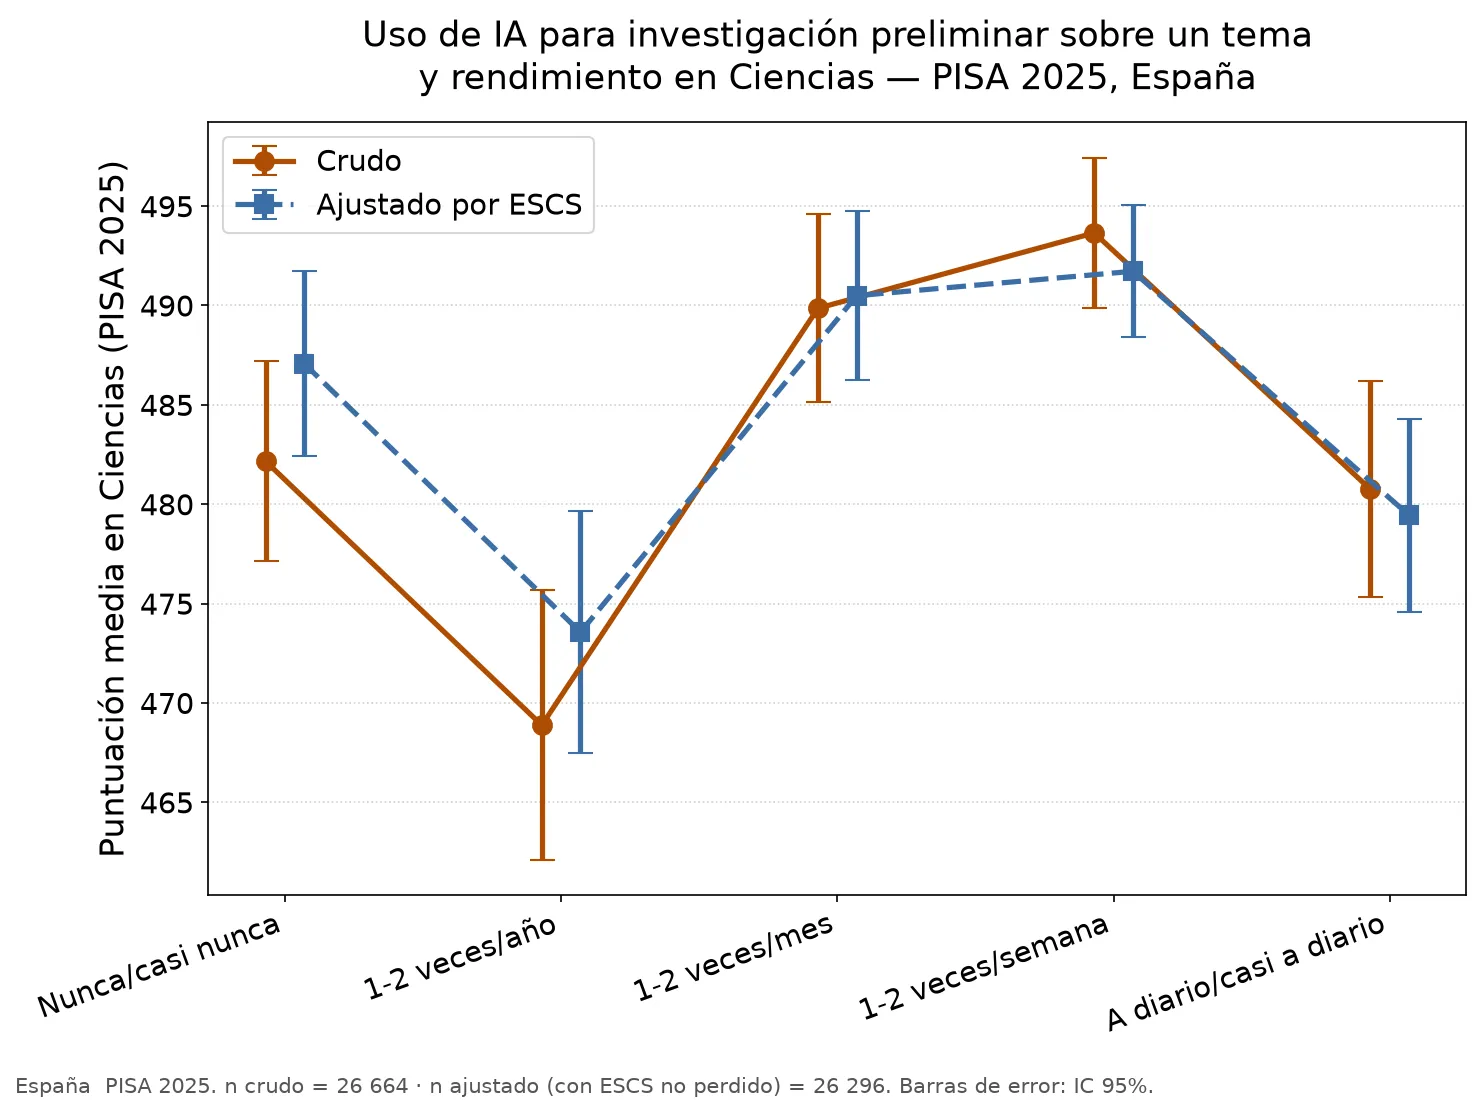
Uso del chatbot para buscar información: la media estimada más alta está en quien lo usa una o dos veces por semana, por encima incluso de quien nunca lo usa para esto; la más baja, en el uso muy ocasional.
Redactar un trabajo. De las cuatro, esta es la tarea con la curva más simple: la nota baja ya desde “nunca” y se mantiene relativamente estable, con pequeñas oscilaciones, entre el uso ocasional y el semanal, sin un pico claro por encima de “nunca”. El uso diario tiene la nota media más baja de los cinco grupos, aunque sus intervalos de confianza se solapan visualmente con los de “1-2 veces/semana” y “1-2 veces/mes” (ver limitaciones sobre qué implica ese solapamiento).
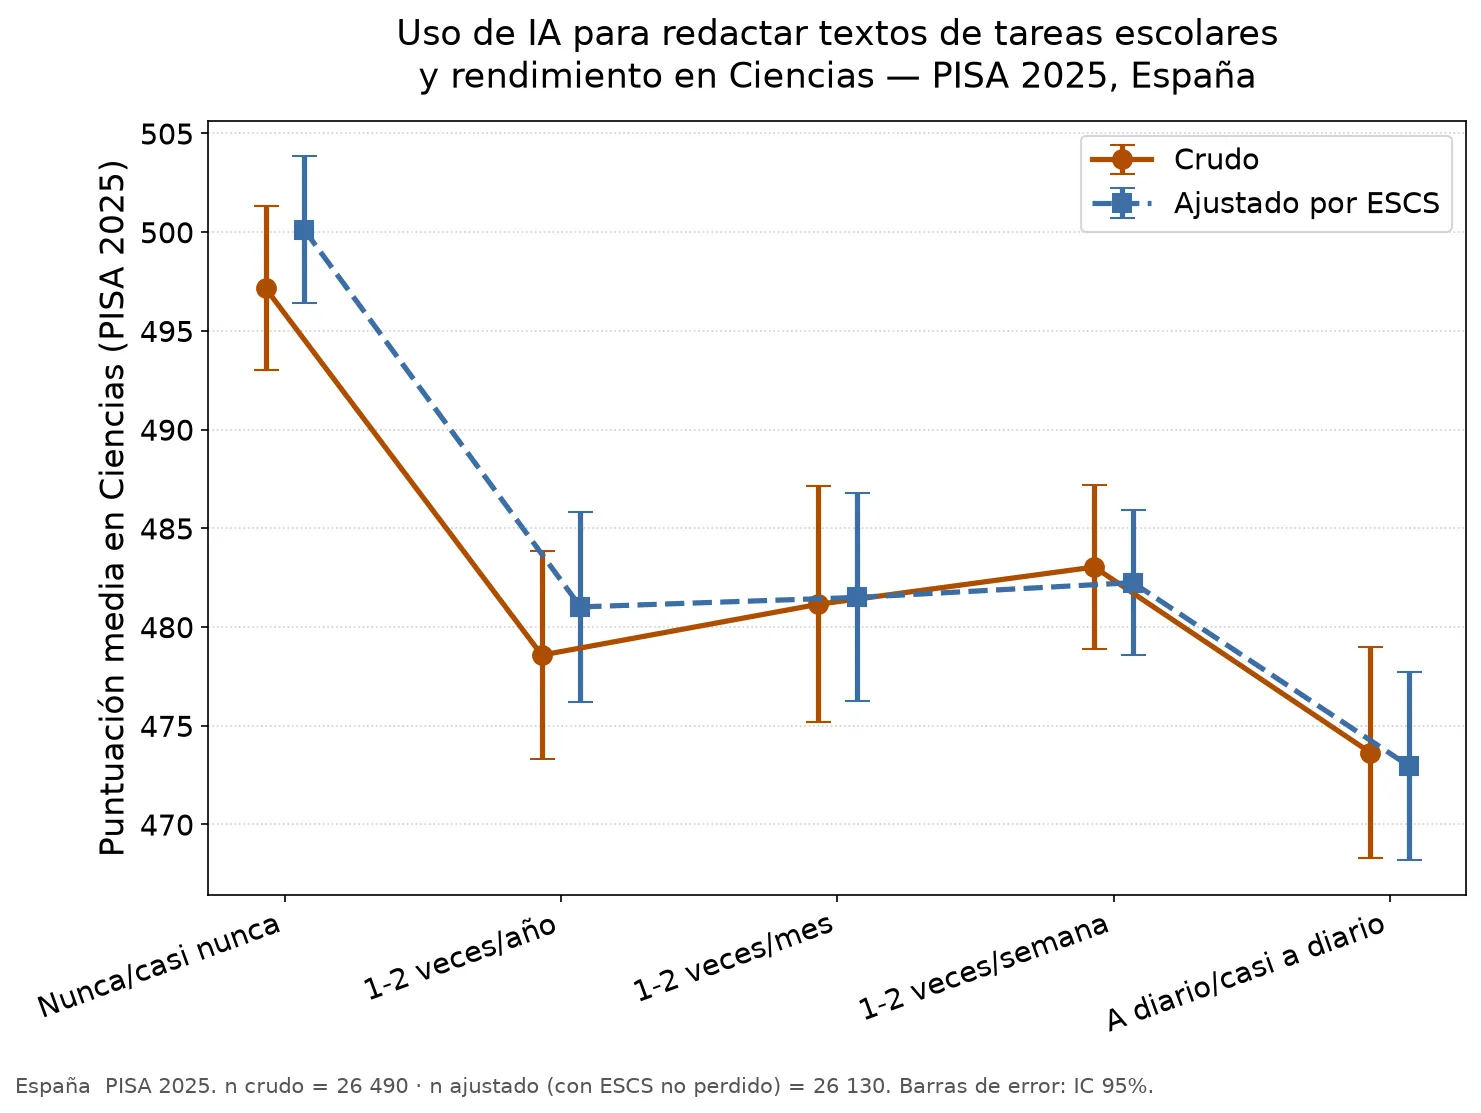
Uso del chatbot para redactar trabajos: la nota media más baja está en el uso diario; sus intervalos de confianza se solapan visualmente con los de uso semanal y mensual, y este análisis no calcula un contraste directo de esa diferencia.
Uso del chatbot para “ayudarme a aprender”. Este ítem solo pregunta con qué frecuencia se usa el chatbot con ese propósito declarado — no pregunta por guía del profesorado ni por ningún tipo de reflexión, así que lo trato como lo que es: una frecuencia de uso más, no una medida de uso “guiado” o “reflexivo”. Tampoco sigue una línea clara: la nota más baja está en el uso muy ocasional y la más alta en el uso semanal, y el uso diario baja un poco respecto al semanal. La diferencia entre “nunca” y el uso ocasional, eso sí, tiene intervalos de confianza que se solapan visualmente (ver limitaciones).
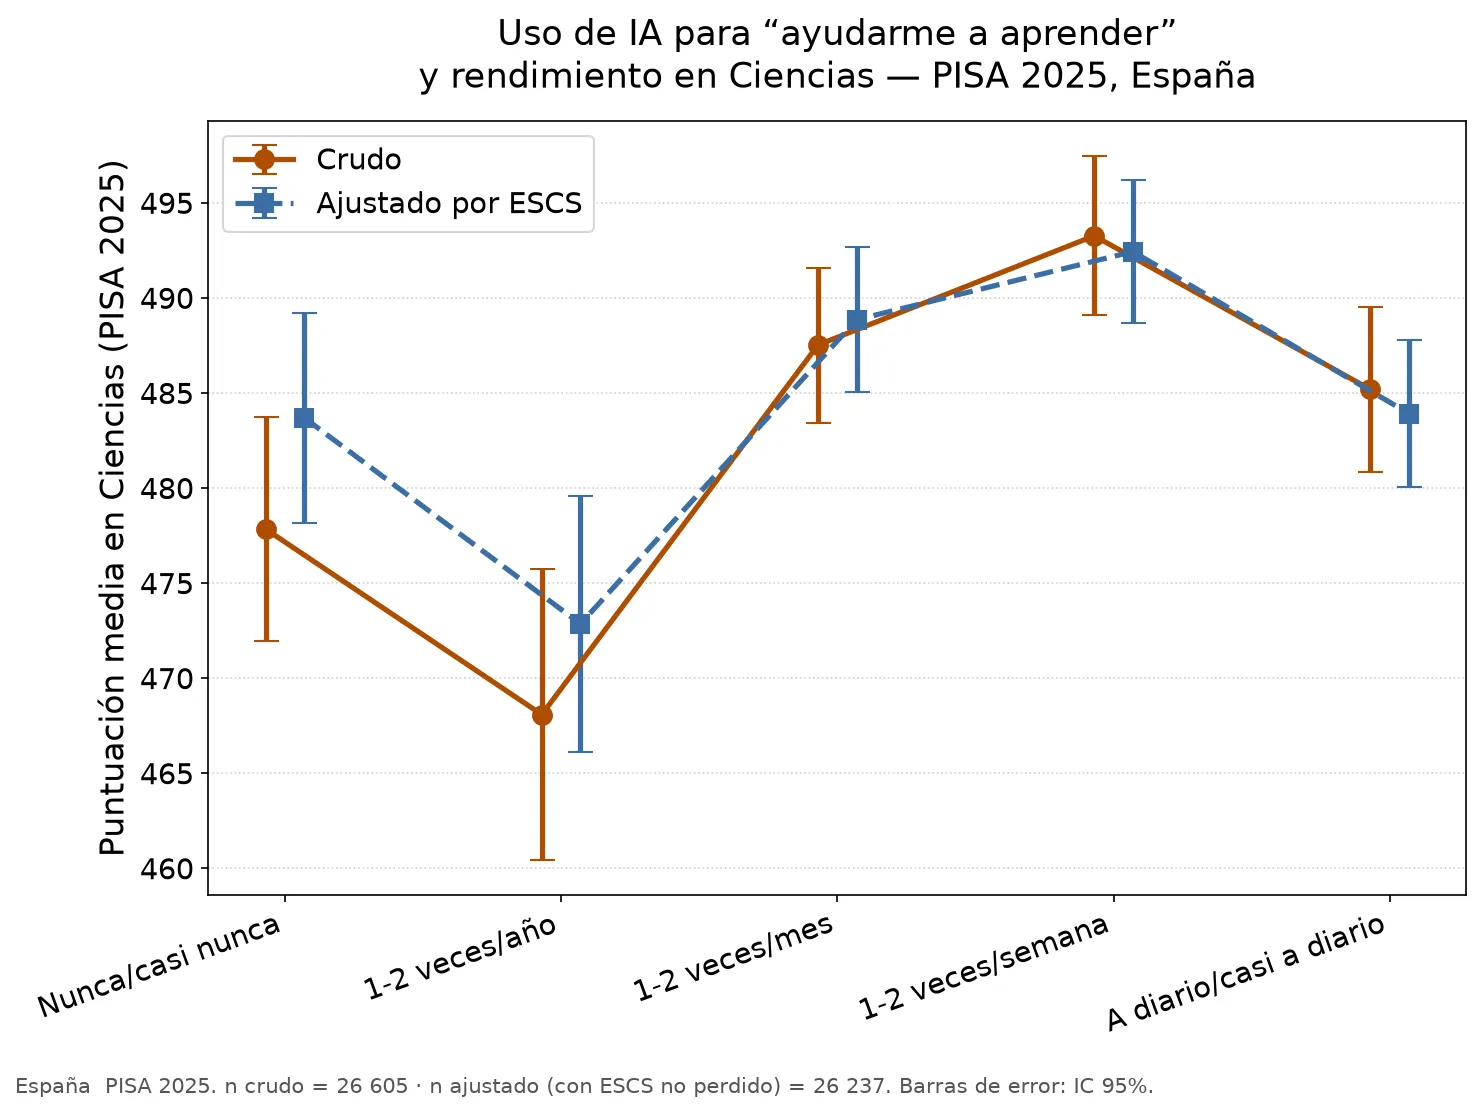
Uso del chatbot para “ayudarme a aprender”: tampoco esta tarea sigue una línea clara; el pico está en el uso semanal.
El ajuste por ESCS modifica las estimaciones, pero no elimina el carácter no monotónico de los patrones en ninguna de las cuatro tareas; por tanto, esas diferencias no se explican únicamente por la variación socioeconómica captada por ese índice. Aquí también aplica el mismo matiz sobre la muestra ajustada: para el uso de IA, el efecto de excluir ese ~1,4% sin dato de ESCS y el efecto del ajuste real son, en general, de magnitud similar — salvo en dos categorías de uso muy poco frecuente (en “buscar información” y en “ayudarme a aprender”), donde el ajuste por ESCS domina con claridad sobre el efecto de la exclusión muestral.
La idea con la que empecé, y que el dato no confirma
Empecé este análisis esperando que el uso del chatbot mostrara una relación tan clara como la de la distracción: que usarlo para que la máquina haga el trabajo por ti perjudicara la nota, y que usarlo con más criterio la protegiera, en una relación fácil de dibujar como una línea. No es lo que encuentro. Y hay algo igual de importante que tengo que decir con la misma claridad: con este tipo de dato, tomado en un único momento, no puedo saber qué es la causa y qué es la consecuencia.
Hay varias explicaciones compatibles con estos resultados, y este diseño no permite distinguir entre ellas. Por ejemplo:
- Puede que usar mucho el chatbot sea una consecuencia de ir ya mal en clase (el estudiante que tiene más dificultades recurre más a la herramienta), y no la causa de sacar peor nota.
- Determinados patrones de uso podrían ser un marcador de hábitos de estudio, competencia digital o rendimiento previo, y no su causa: quien ya sabe estudiar bien podría usar el chatbot de forma distinta a quien no, sin que eso implique que ese patrón de uso sea la causa de la nota.
Con una sola foto fija —sin seguir a los mismos estudiantes a lo largo del tiempo— no puedo descartar ninguna de ellas. Lo que muestran las medias estimadas es un perfil no monotónico cuya forma depende de la tarea; este diseño no permite explicar por qué.
Sobre la cifra del “año escolar completo”
La cifra que abría este artículo —que usar el chatbot “bien” equivale a ganar un año escolar entero frente a usarlo “mal”— circula atribuida a la OCDE, pero casi siempre sin decir de dónde sale exactamente. Esta vez sí localicé la fuente concreta: el informe oficial PISA 2025 Results, Volume I, publicado por la OCDE el 8 de septiembre de 2026, documenta ese benchmark de aproximadamente 20 puntos ≈ 1 año de aprendizaje en un recuadro identificado como “Box I.2.2”.
Con una precisión importante que conviene no pasar por alto: ese Box I.2.2 es un benchmark general para interpretar cambios de puntuación a través del tiempo, entre ciclos de PISA — no algo que el capítulo del informe dedicado específicamente a la IA aplique al hallazgo sobre frecuencia de uso de chatbots. La combinación concreta que circula (“usar la IA bien o mal equivale a un año escolar”) es una conversión hecha por cobertura secundaria de terceros, que junta dos partes distintas del informe — el benchmark general de un lado, el hallazgo sobre IA del otro —, no algo que la OCDE afirme literalmente en esos términos en su capítulo de IA.
Intenté recalcular esa conversión yo mismo con el fichero público (Public Use File) y no pude: el benchmark de los 20 puntos no es una variable que falte en el PUF 2025, es una estimación independiente que la OCDE construye con una metodología propia sobre otros datos y ciclos, así que no hay forma de reproducirla a partir de este fichero aislado. La cifra tiene ahora una fuente concreta y localizable, pero sigue siendo algo que no he verificado de forma independiente con mis propios medios —en la bibliografía dejo la referencia exacta, con esa salvedad.
Limitaciones de este análisis
Antes de las conclusiones, conviene reunir aquí las limitaciones del diseño completas, en vez de la nota breve que ya acompaña a cada gráfico. Es un análisis transversal: una sola fotografía en el tiempo que no permite establecer causalidad. Ambas variables proceden de respuestas declaradas por el alumnado en el cuestionario, no de registros objetivos: el uso de chatbots es autoinformado, mientras que la distracción recoge la percepción del alumnado sobre el clima de su clase, no un autoinforme de su propia distracción individual. El ajuste por ESCS reduce, pero no elimina, la posible confusión con otras variables no medidas aquí. Varias de las comparaciones entre categorías de uso (por ejemplo, cuándo los intervalos de confianza se solapan) son descriptivas, sin un contraste estadístico directo entre grupos. Y los resultados se refieren específicamente a alumnado de 15 años en España y a su rendimiento en Ciencias — no son generalizables sin más a otras edades, países o materias.
Qué me llevo de este análisis
Dos conclusiones, ninguna cómoda como titular fácil:
- La distracción por recursos digitales percibida en clase de Ciencias se asocia con peor nota de forma clara y constante, con y sin ajustar por el nivel económico-cultural de la familia. Esto no sorprende, pero ahora lo digo habiendo comprobado el dato yo mismo, no repitiendo lo que dice otro.
- El uso de chatbots de IA en las tareas escolares no sigue ningún patrón simple — ni “cuanto más los uses, peor” ni “úsalos con criterio y sacarás mejor nota” se sostienen como reglas sencillas. Las medias estimadas muestran un perfil no monotónico, cuya forma cambia según la tarea. Un diseño longitudinal permitiría estudiar mejor la secuencia temporal; para estimar efectos causales con mayor solidez serían necesarios diseños experimentales o cuasiexperimentales.
Sigo trabajando con datos abiertos porque prefiero equivocarme con transparencia —enseñando exactamente qué comparé y cómo— a repetir una cifra de otro que no he podido comprobar.
Repite el análisis tú mismo
Los cálculos empíricos de este análisis —las medias, los intervalos de confianza, los gráficos— pueden reproducirse de forma independiente con el dato y el cuaderno de abajo, sin tener que confiar en mi palabra. Dos cosas quedan a tu disposición:
El dato original. El fichero que analicé es el Student Questionnaire Data File de PISA 2025, publicado por la propia OCDE:
- Página oficial de la base de datos de PISA en la OCDE (la OCDE sigue alojando ahí el ciclo 2025, con la curiosidad de la URL que cuento más arriba).
- Descarga directa del fichero exacto que usé (formato SPSS, ~1 GB, respuestas anónimas de más de 755.000 estudiantes de 91 países, incluidos los 29.966 registros españoles que uso aquí).
El cuaderno con todo el proceso. He publicado un cuaderno Jupyter descargable con el análisis completo, de principio a fin: cómo extraer el subconjunto de España del fichero de la OCDE, cómo comprobé que el dato era realmente del ciclo 2025 y no de una edición anterior, la combinación de los diez valores plausibles de rendimiento con el peso muestral y las réplicas de remuestreo (BRR-Fay), el ajuste por nivel socioeconómico-cultural —incluida la comparación de tres pasos (cruda con todos los casos, cruda restringida a quienes tienen dato de ESCS, y ajustada) con la que separo el efecto de excluir el ~1,4% sin ESCS del efecto real del ajuste—, y el código que genera los cinco gráficos de este artículo. Está pensado para que cualquiera —con conocimientos básicos de Python— pueda ejecutarlo sobre el mismo fichero y comprobar que llega exactamente a las mismas cifras, o para que lo adapte y compruebe otras preguntas sobre el mismo dataset.
Dos análisis hermanos en xiringase.com
Este análisis es parte de una conversación más amplia sobre PISA 2025 y tecnología que sigo en xiringase.com, la marca hermana de este ecosistema. Dos piezas complementarias tratan el mismo dataset desde otros ángulos: PISA 2025 y la tecnología en el aula, sobre dispositivos y distracción digital en general, y PISA 2025 y la IA: por qué la pregunta correcta no es qué chatbot usas, sino cómo lo usas, que retoma directamente el hallazgo de este análisis —la ausencia de un patrón simple por tipo de tarea— para preguntarse qué significa eso para el criterio con que se usa la IA en el aula.
Bibliografía
- OCDE. PISA 2025 Database. Organización para la Cooperación y el Desarrollo Económicos.
- OCDE. PISA — Programme for International Student Assessment. Página oficial del programa.
- OCDE. PISA 2025 Results (Volume I). Publicado el 8 de septiembre de 2026. Fuente del benchmark de aproximadamente 20 puntos ≈ 1 año de aprendizaje mencionado en este artículo, documentado en el recuadro “Box I.2.2”; no recalculado con el PUF 2025 porque el benchmark procede de una estimación independiente basada en información de varios ciclos, no de una variable contenida en este fichero. Consultar el catálogo de publicaciones de PISA 2025 en oecd.org para la edición exacta.
- OCDE. PISA 2025 Results (Volume I) — Country Notes: Spain. Fuente de la tasa de exclusión muestral de España (7,9%), del desglose por comunidad autónoma (Cataluña, Murcia) y de la advertencia explícita de la propia OCDE sobre el posible sesgo al alza que introduce esa exclusión.
- OCDE. PISA 2025 Database — Student Questionnaire y Codebook & Compendia. Fuente de la formulación y codificación exacta de los ítems
ST097Q06DA(distracción por recursos digitales) yST438Q01DA–ST438Q04DA(uso de chatbots de IA) descritos en este artículo.