Essai · Labo DIY
Peut-on séparer le bourdon de la cornemuse dans un enregistrement de terrain ?
On a confié à un algorithme un enregistrement vieux de presque 50 ans d'un véritable sonneur de cornemuse de Teverga, et on a tenté de séparer le bourdon de la mélodie avant de l'analyser. La technique standard pour cela, le HPSS, est celle qu'on a utilisée dans cette petite expérience — et voici le résultat, en toute honnêteté.
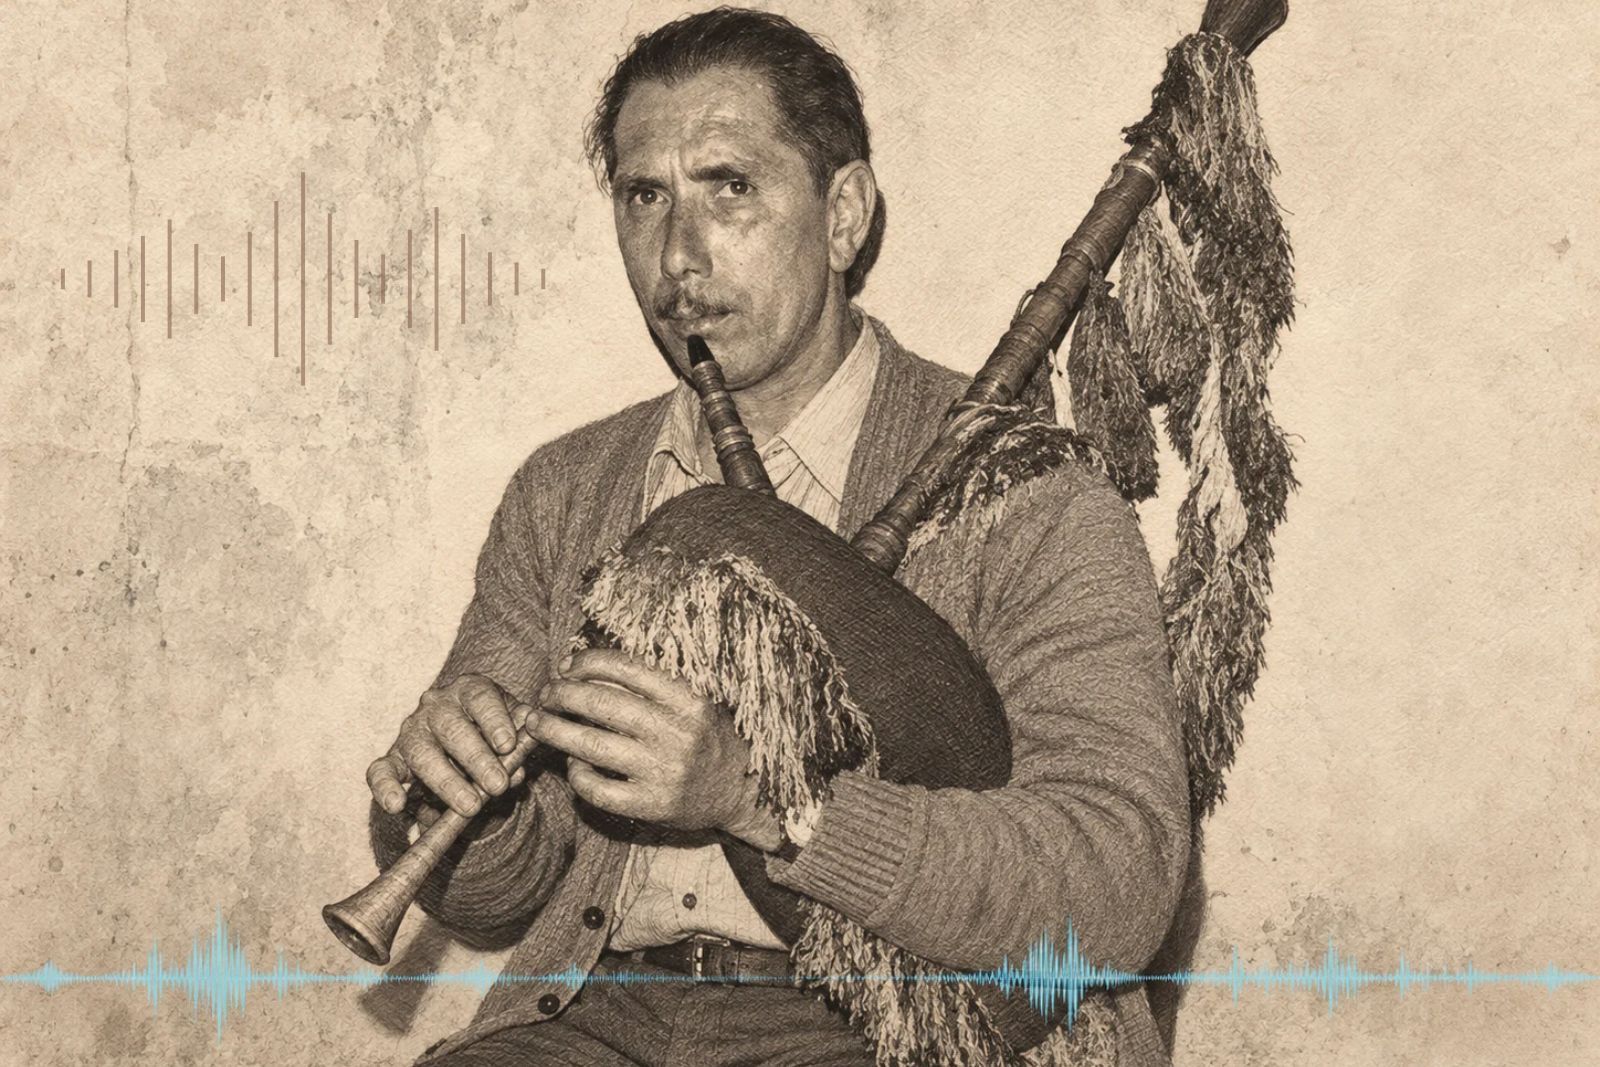
En avril 1976, Celso Peyroux enregistre sur cassette Juan Huerta, sonneur de cornemuse de La Torre (Teverga), en train de jouer de la cornemuse asturienne. La bande se trouve aujourd’hui dans les Archives Sonores de Celso lui-même, et la fiche du catalogue le décrit ainsi : « un des grands sonneurs qu’ait eus Teverga, avec Julio de Fresnedo et Floro Regina. Ils jouaient pour le baile agarrao [danse de couple enlacé]. » Près de cinquante ans plus tard, j’ai fait passer un extrait de cet enregistrement à un algorithme pour tenter de répondre à une question très précise : un programme peut-il séparer automatiquement le roncón (le bourdon continu) de la mélodie du punteru (le chalumeau), les deux voix qui sonnent en même temps dans une cornemuse ? Et s’il y parvient, cela aide-t-il vraiment à mieux comprendre la musique ?
L’outil que j’utilise pour cela s’appelle le Music Information Retrieval (MIR) : la branche de l’informatique qui apprend à un ordinateur à « écouter » de l’audio et à en extraire des informations — quand chaque note commence, quelle hauteur elle a, à quel volume elle sonne. Ce n’est ni de la magie ni de l’intelligence artificielle au sens où elle « comprendrait » la musique : ce sont des algorithmes qui mesurent des motifs dans l’onde sonore.
Cette expérience n’est ni un portrait musical de Juan Huerta ni une pièce d’ethnomusicologie — ce regard humain sur sa figure, je le raconte sur tever.es, dans Gaiteros de la Tradición #4. Ici, je reste sur le terrain technique, mais raconté pour quiconque n’a jamais regardé un spectrogramme de sa vie.
Pourquoi le bourdon est le problème de fond
Quand une cornemuse asturienne sonne, on entend en réalité deux instruments mélangés en un seul son, sans aucun moyen de les séparer à l’oreille : le roncón (ou bourdon), un tuyau qui produit une unique note fixe et continue pendant toute la pièce — comme un bourdonnement grave de fond qui ne s’arrête jamais —, et le punteru, le tuyau à trous qui joue la mélodie au-dessus. Pensez au roncón comme à la basse d’un groupe qui ne cesse jamais de jouer la même note : il n’y a même pas un bref silence où on pourrait « l’entendre seul » pour apprendre à quoi il ressemble isolé. Il est toujours là, mélangé, tout le temps.
C’est un problème pour n’importe quel algorithme. Si l’on veut qu’un programme n’analyse que la mélodie — seulement le punteru —, il faudrait d’abord écarter ce bourdonnement constant du roncón. Et comme il n’existe jamais de trou de silence où apprendre « ceci n’est que du bruit de fond », l’algorithme part avec un vrai handicap.
Cet article raconte l’expérience en cinq étapes :
- J’examine la qualité de l’enregistrement lui-même.
- Je localise le roncón dans le son.
- J’analyse la pièce complète telle qu’elle arrive, sans la toucher.
- Je tente de séparer le roncón de la mélodie.
- Je compare si cette séparation a amélioré quelque chose ou non.
Avant d’entrer dans le détail technique, voici ce qui est analysé : 19 secondes de cette bande de 1976, telles qu’elles sonnent, sans nettoyage. Précisément, il s’agit du floréu d’entamu — le fleuretis d’ouverture — d’un entemediu de misa : une pièce brève jouée pendant les pauses de la messe.
Quelle est la qualité de l’enregistrement
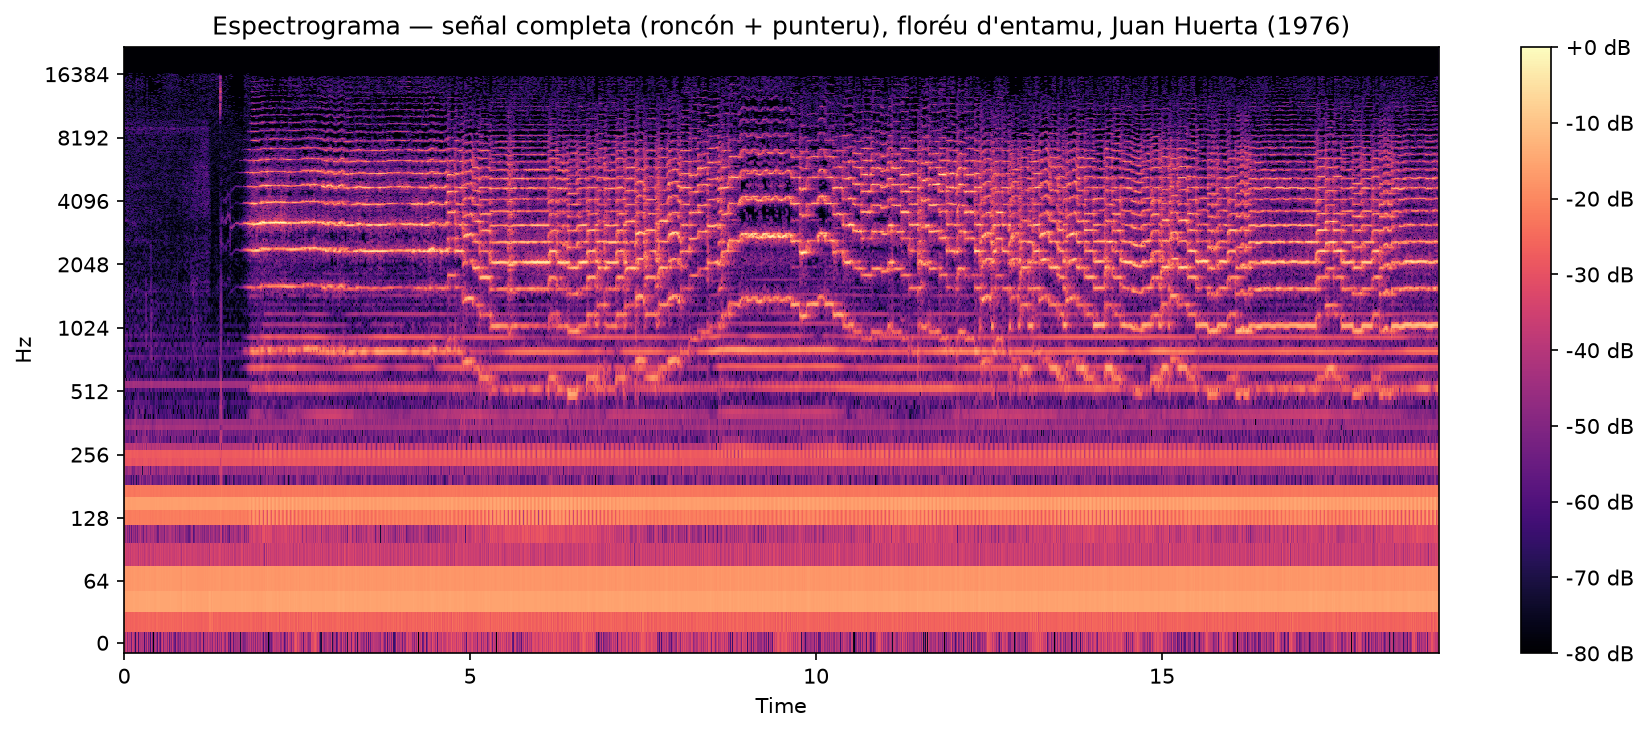
C’est une bande de terrain enregistrée sur cassette en 1976, pas une prise de studio, et cela se remarque dans l’audio lui-même, de façon mesurable. Pour le voir, j’utilise un spectrogramme : une image qui montre quelles fréquences (graves, aiguës) sonnent à chaque instant, une sorte de « radiographie » du son au fil du temps. Dans cette image apparaît un bruit de fond très typique des appareils électriques anciens — le bourdonnement du courant — à 49,80 Hz, avec un écho plus aigu à 150,7 Hz, presque exactement le triple de cette fréquence (150,7 divisé par 49,80 donne 3,03, pratiquement 3). Cela correspond à du bruit électrique de réseau, pas à quoi que ce soit de musical : les deux tons sonnent avec une stabilité quasi parfaite — ils varient à peine d’un instant à l’autre —, et cette immobilité absolue est précisément la signature d’un bourdonnement de fond, pas d’une note jouée par une personne.
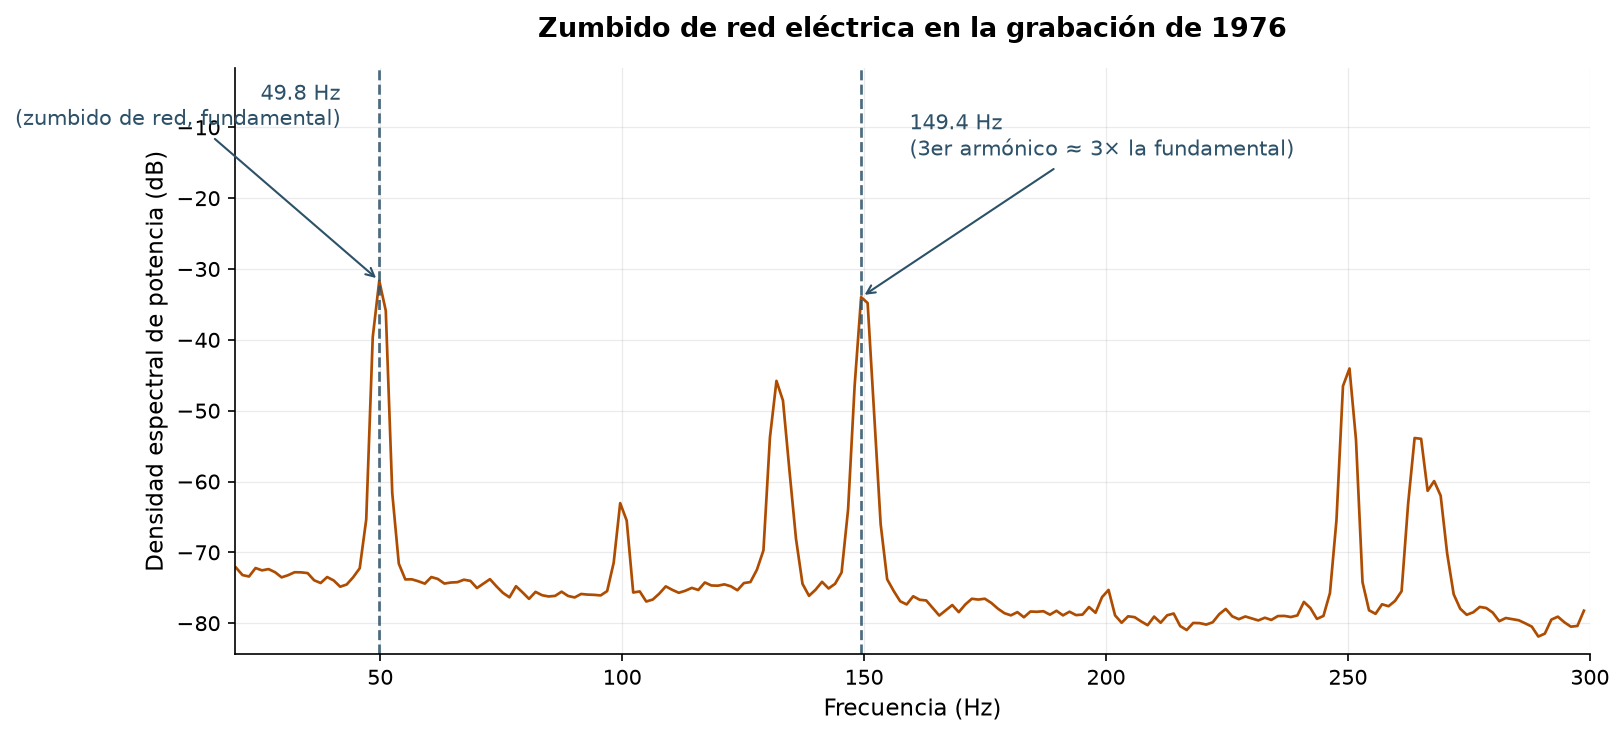
Les deux pics du bourdonnement du réseau électrique, presque trois fois plus aigu l’un que l’autre : la signature indiscutable d’un appareil ancien, pas de quelque chose de musical.
Pour ce qui est du volume de l’enregistrement, plus ou moins fort : je le mesure avec le RMS, une méthode standard pour calculer « à quel volume moyen sonne » un signal (à la différence du pic le plus haut ponctuel, le RMS résume le volume soutenu). En décibels (dB, l’unité avec laquelle on mesure le volume : plus il y a de dB, plus c’est fort), cette moyenne varie de 15,2 dB entre les moments les plus faibles et les plus forts de la pièce complète. Une précision honnête s’impose ici : dans un enregistrement de cornemuse asturienne, il n’existe aucun moment de silence réel à mesurer, car le roncón sonne tout le temps — je ne peux donc pas comparer « signal contre silence » pour calculer à quel point l’enregistrement est propre, comme je pourrais le faire avec une voix ou un piano, qui eux se taisent entre les phrases. Je mesure donc à la place combien le volume du mélange complet monte et descend : c’est la mesure qui a du sens quand le « fond » ne cesse jamais de sonner.
Où vit le bourdon dans le son
Avant de tenter de le séparer, il me fallait confirmer exactement à quelle fréquence vit le roncón. Pour ne pas le confondre avec le bourdonnement secteur de la section précédente — un piège réel, car ses harmoniques tombent proches de la bande du roncón —, j’ai relocalisé ce bourdonnement avec précision (49,80 Hz) et divisé l’extrait en 18 fenêtres d’une seconde, en observant dans chacune quelle était la fréquence la plus forte et en écartant tout candidat trop proche des harmoniques du bourdonnement. La véritable fondamentale du roncón est la fréquence qui gagne le plus souvent parmi ces 18 fenêtres.
Le résultat : 132,0 Hz, note Do3, avec 12 des 18 fenêtres votant pour cette valeur comme fondamentale — un résultat dominant et cohérent. Pour mesurer à quel point cet accord s’éloigne de l’accord « officiel », les musiciens utilisent les cents : chaque demi-ton se divise en 100 parts égales, si bien qu’une note à +15,6 cents n’est qu’à un sixième de demi-ton au-dessus du standard — une différence si petite que presque aucune oreille ne la perçoit. Par rapport au Do3 standard d’un accord en La 440, cela donne +15,6 cents : pratiquement l’accord standard, légèrement haut. Cette fréquence apparaît de façon marquée dans 55,4 % des fenêtres analysées. Au-dessus de la fondamentale, le roncón génère aussi des harmoniques : des échos plus aigus à des multiples exacts de la fréquence de base. Ces harmoniques varient davantage en intensité car elles se mélangent acoustiquement avec la mélodie du punteru qui sonne au-dessus — seule la note fondamentale du roncón conserve cette stabilité caractéristique d’un bourdon.
Que le roncón sonne en Do n’est ni un hasard ni un choix libre de l’instrument : c’est l’accompagnement harmonique que porte la cornemuse quand elle joue seule ou seulement avec le tambour, et c’est pourquoi sa note est toujours la tonique du punteru — la note de repos, sur laquelle la mélodie se résout — mais deux octaves sous le Do grave (Do5) que joue le punteru lui-même. Mesurer 132 Hz et vérifier qu’il s’agit du Do3 n’est pas qu’une donnée d’accordage : c’est la confirmation que cette cornemuse est, en effet, accordée en Do.
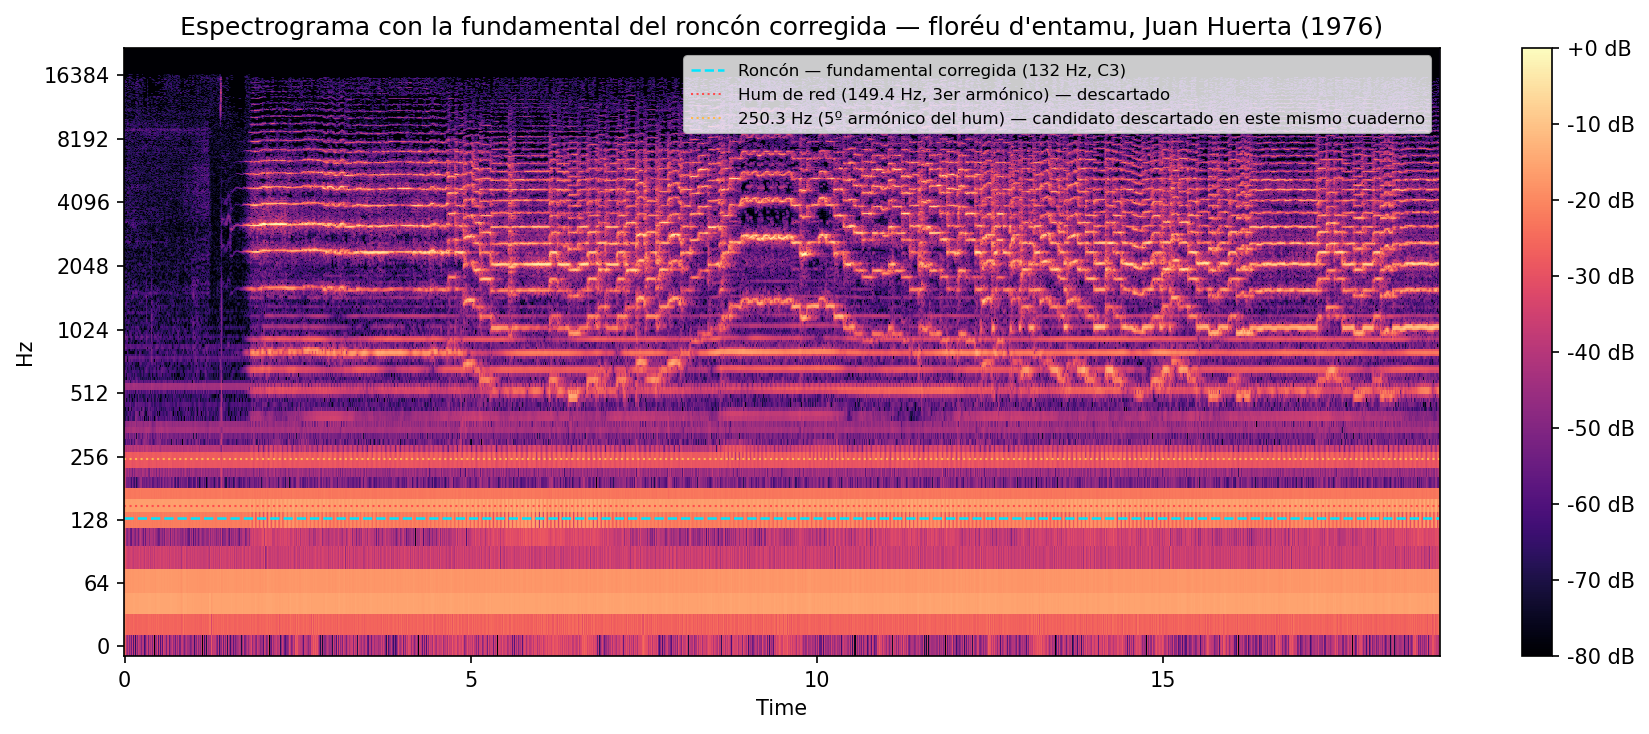
Le roncón marqué sur le spectrogramme : sa note principale, à 132,0 Hz (Do3), reste une bande horizontale constante durant toute la pièce — sont aussi marqués les candidats écartés comme fuite spectrale du bourdonnement secteur.
La pièce telle quelle : bourdon et mélodie mélangés
Avant de toucher quoi que ce soit de l’audio, j’ai analysé l’enregistrement complet tel qu’il est arrivé, avec deux outils différents.
Le premier recherche les onsets : l’instant exact où commence chaque note, l’« attaque » du son. C’est la première chose dont a besoin tout système voulant transcrire une pièce en partition : savoir quand quelque chose se produit. Sur les 19 secondes de cet enregistrement, l’algorithme détecte 127 onsets — presque 7 nouvelles notes par seconde, un rythme dense, typique de la cornemuse asturienne.
La seconde tâche est le suivi de hauteur (pitch-tracking) : déterminer, instant par instant, quelle note exacte est jouée. J’utilise pour cela une méthode appelée pYIN : un algorithme qui, à chaque fraction de seconde, calcule la fréquence la plus probable en train de sonner et avec quel degré de confiance il l’affirme — il ne devine pas, il mesure —, limité à la gamme de notes réelle que peut jouer un punteru de cornemuse asturienne. Le résultat : il parvient à détecter une hauteur claire dans 92,7 % des instants analysés — pratiquement sur tout l’extrait, ne se trompant qu’environ 1 instant sur 13.
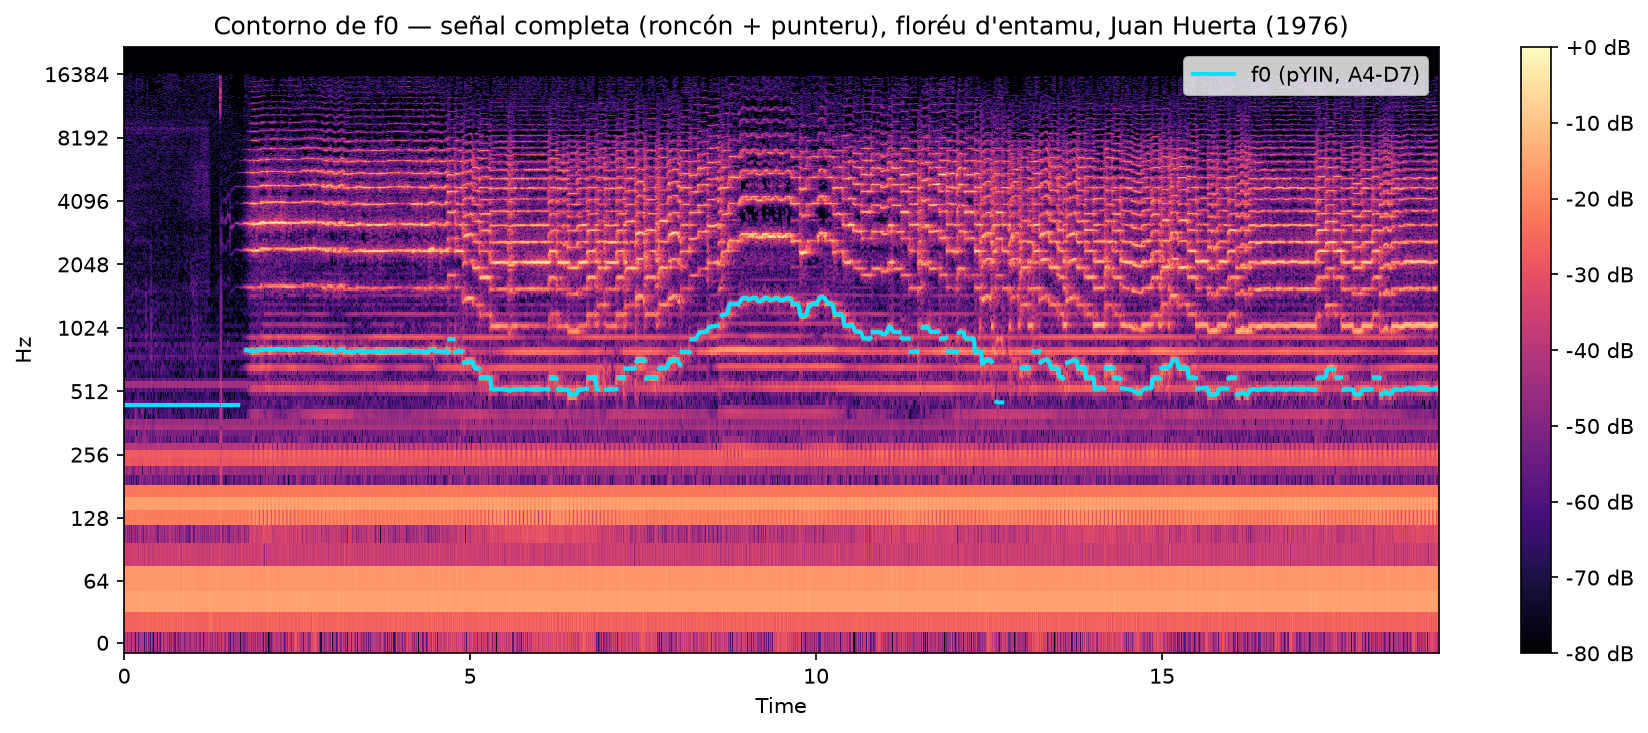
Quel est le rapport entre cette ligne et la pièce réelle ? Dans mes cours, j’enseigne le floréu d’entamu avec un schéma en trois parties — ouverture, corps et conclusion —, chacune avec ses notes de référence :
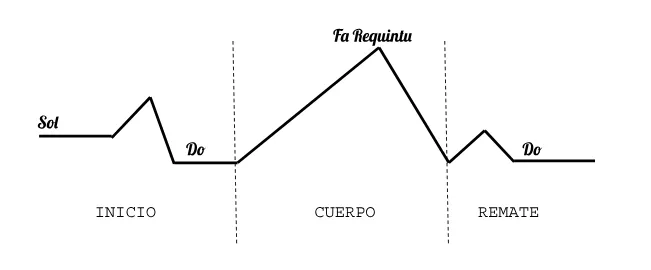
En confrontant la ligne de f0 à ce schéma, ce que l’algorithme détecte correspond aux trois parties, même si dans l’ouverture la forme réelle est plus contenue que celle du schéma « de manuel » :
- Le pic du corps correspond précisément. La fréquence la plus aiguë de tout l’extrait — 1437,8 Hz, note Fa6 — apparaît à la seconde 10,08, en plein milieu du corps. C’est exactement la note que le schéma marque comme point culminant : le Fa Requintu.
- La conclusion correspond également. Dans les trois dernières secondes, le Do (Do5) est, de loin, la note qui apparaît le plus : 167 des quelque 238 instants analysés. Le schéma clôt la pièce sur le Do, et c’est exactement ce que mesure l’algorithme.
- L’ouverture correspond, mais avec une montée plus courte que celle du schéma. La ligne réelle monte jusqu’au La4 (A) — pas jusqu’à un Do aigu, comme le feraient des fleuretis plus expansifs, dans le style de José Remis Ovalle (l’un des maîtres qui a créé une école en Asturies, avec une manière de fleureter si reconnaissable que de nombreux sonneurs l’ont imitée) — et redescend de là pour se poser sur le Do (Do5) à partir de la seconde 5,3. C’est la même forme de fond que dessine le schéma — monter et revenir au Do —, mais avec un saut plus court : un choix de style propre, pas un défaut du schéma ni de l’algorithme.
Cette nuance dans l’ouverture est, en fait, la partie la plus intéressante de la comparaison : le schéma donne la forme générale de la phrase — où elle monte, où elle descend, où elle conclut —, mais ne fixe pas l’amplitude exacte de chaque fleuretis, qui varie selon qui joue et comment. Comparer l’analyse automatique à la forme « de manuel » d’une pièce est une façon réelle de voir, note par note, comment une interprétation concrète se déplace dans cette forme.
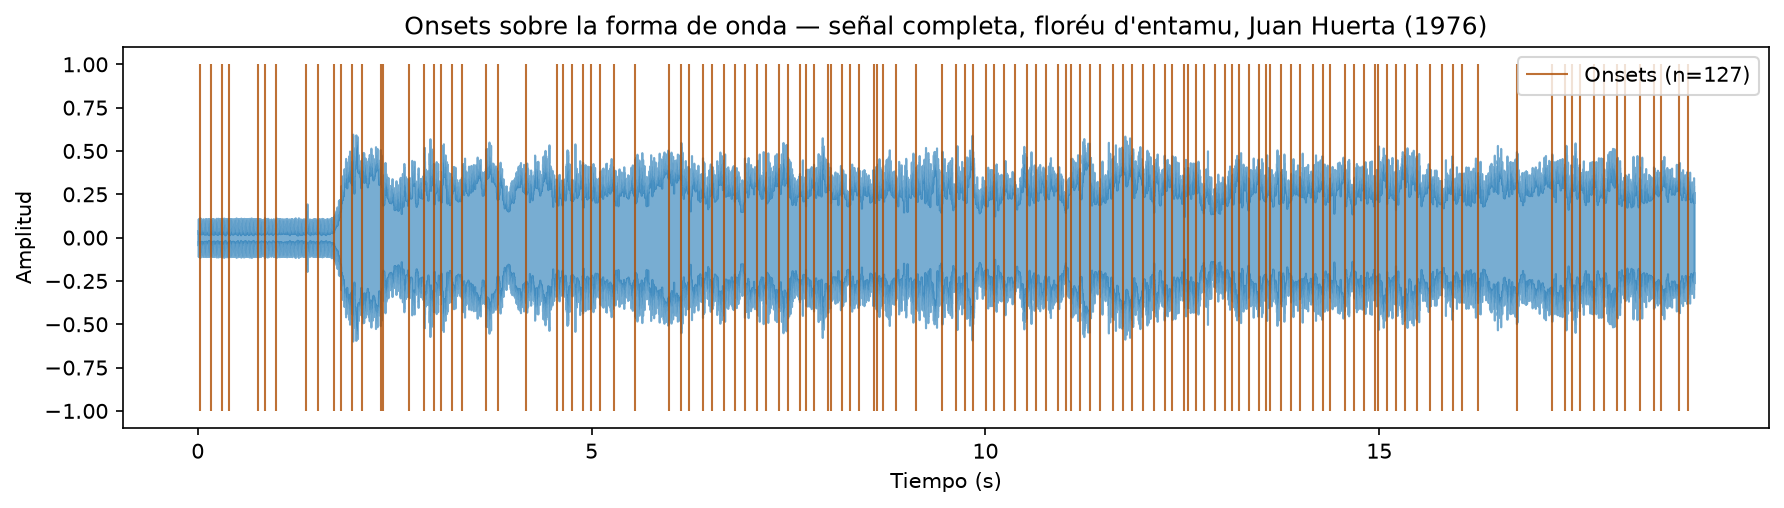
Ces trois résultats constituent le point de départ : ce que donne l’analyse sans toucher à l’audio. La question suivante est de savoir si retirer le roncón avant d’analyser améliore cela.
Peut-on séparer le bourdon de l’interprétation ?
Pour tenter d’écarter le roncón, j’ai testé la technique standard utilisée dans ces cas : le HPSS (Harmonic-Percussive Source Separation, séparation harmonico-percussive). Imaginez-le comme un tamis — une passoire avec une maille qui laisse passer certaines choses et retient les autres — qui filtre le son en deux plateaux : dans l’un tombent les sons « d’attaque » — percussifs, comme une grosse caisse ou un claquement, qui commencent brusquement et s’éteignent vite — et dans l’autre tombent les sons « soutenus » — harmoniques, comme une note de piano ou de violon maintenue dans le temps. Le roncón est, par définition, un son soutenu pur : il n’attaque pas brusquement, il sonne toujours pareil. Le pari était raisonnable : si le tamis sépare bien le soutenu du percussif, le roncón devrait tomber entièrement dans l’un des deux plateaux, laissant l’autre plus propre.
Le résultat est que le tamis ne fonctionne pas ici, et cela vaut la peine d’expliquer pourquoi. Le HPSS a été conçu pour des cas comme séparer un piano d’une batterie : là, il existe une vraie frontière entre « sonne brusquement » et « sonne de façon soutenue ». Mais dans la cornemuse asturienne, tant le roncón que la mélodie du punteru sont des sons soutenus — aucun des deux n’est percussif, aucun n’« attaque brusquement » puis ne s’éteint. Pour le tamis, roncón et mélodie sont le même grain de son : les deux tombent dans le même plateau, sans qu’il soit possible de les différencier par cette voie.
Les chiffres le confirment. En mesurant à nouveau avec le RMS — le même « combien ça sonne en moyenne » que dans la section précédente — le plateau « soutenu » conserve 92,5 % de l’énergie totale du son — le roncón y va presque entièrement, entraînant avec lui une bonne part de la mélodie. Le plateau « d’attaque » n’en retient à peine que 19,0 %. Et si l’on observe spécifiquement combien d’énergie du roncón reste dans chaque plateau, la différence demeure énorme : le plateau soutenu contient 77 fois plus d’énergie du roncón que le plateau percussif — en utilisant la bande de fréquence correcte (132 Hz, désormais sans la contamination du bourdonnement secteur), plutôt que la bande gonflée de la version précédente. À première vue, cela pourrait sembler une séparation très nette du roncón — mais ce n’en est pas une : ce qui s’est réellement passé, c’est que le tamis a poussé presque tout ce qui est soutenu, roncón et mélodie ensemble, du même côté.
Comme comparaison plus simple, j’ai aussi testé un filtre coupe-bande (notch) : au lieu d’un tamis qui classe, c’est un bistouri qui tranche chirurgicalement une unique fréquence exacte — ici, les 132 Hz du roncón — en laissant tout le reste intact. Le résultat de cette comparaison se trouve dans la section suivante.
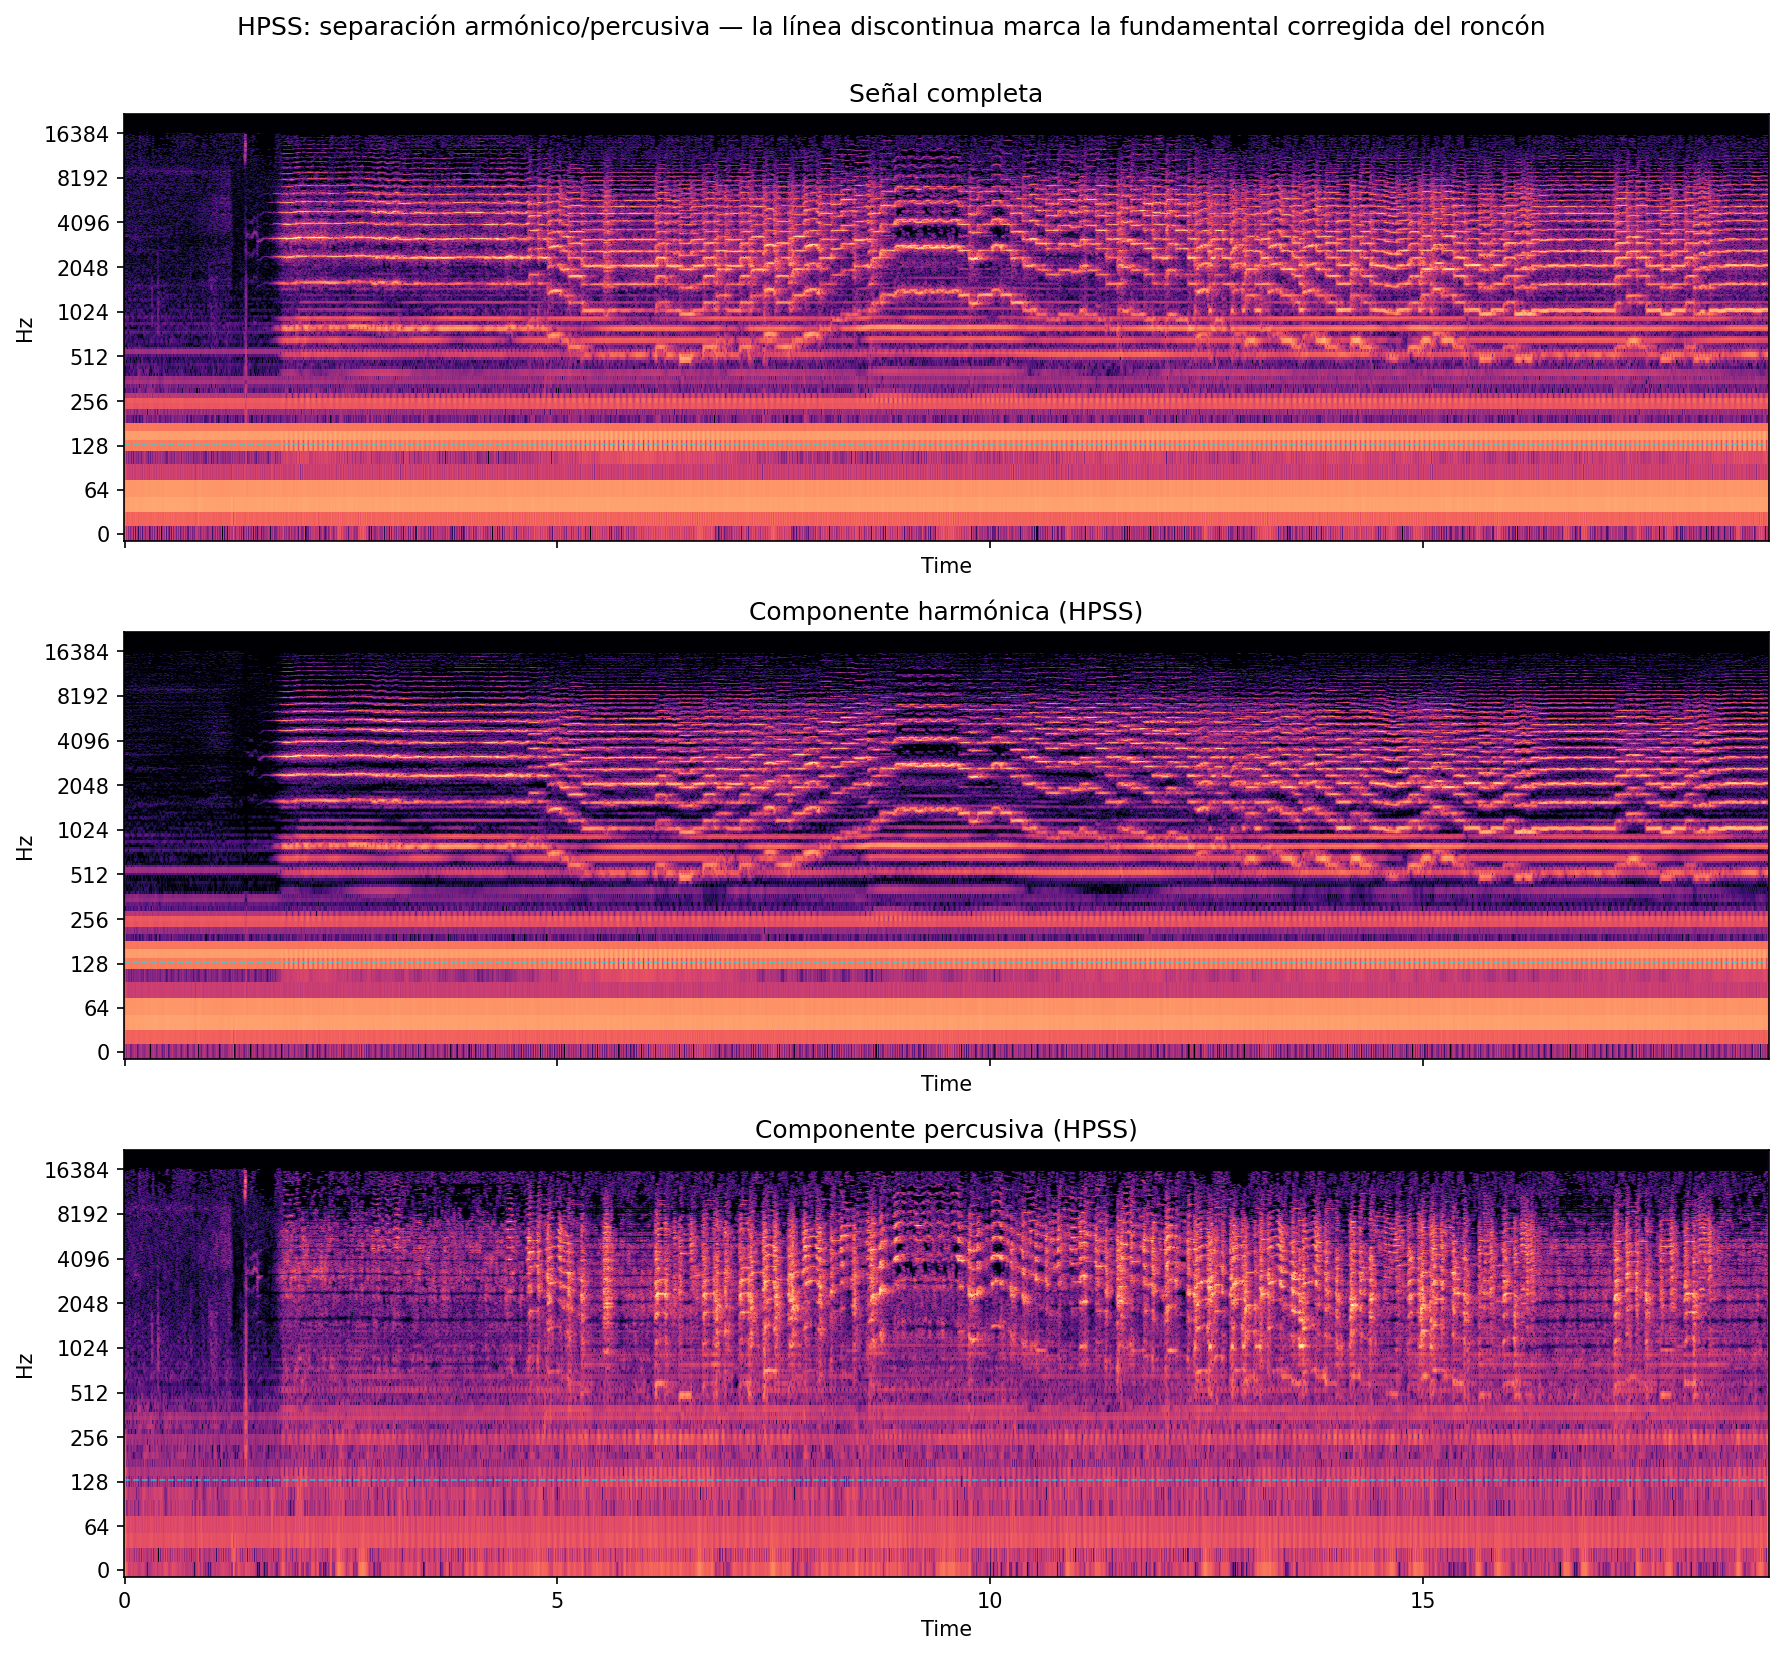
Comparaison HPSS : signal complet, plateau « soutenu » (conserve 92,5 % du son, roncón inclus) et plateau « d’attaque » (seulement 19,0 %).
Ce que ce résultat dit en réalité
Ce n’est pas seulement « la technique a échoué » — c’est une découverte sur ce que signifie « séparer le roncón » pour cet instrument en particulier. Le tamis du HPSS ne peut pas distinguer « roncón soutenu » de « note soutenue du punteru », car pour lui, les deux sont exactement le même type de son. Le résultat de la section suivante — le suivi de hauteur se détériore beaucoup, les onsets changent à peine — confirme que séparer selon « soutenu contre brusque » est le mauvais outil pour ce cas, et non qu’il soit impossible de séparer roncón et mélodie avec n’importe quelle technique. C’est une donnée réelle et utile : elle explique précisément pourquoi la cornemuse asturienne — un bourdon continu et une mélodie, tous deux soutenus, sonnant en même temps — est un cas authentiquement difficile pour ce type d’analyse automatique, au-delà du simple « c’est un enregistrement vieux et bruyant ».
L’analyse après séparation
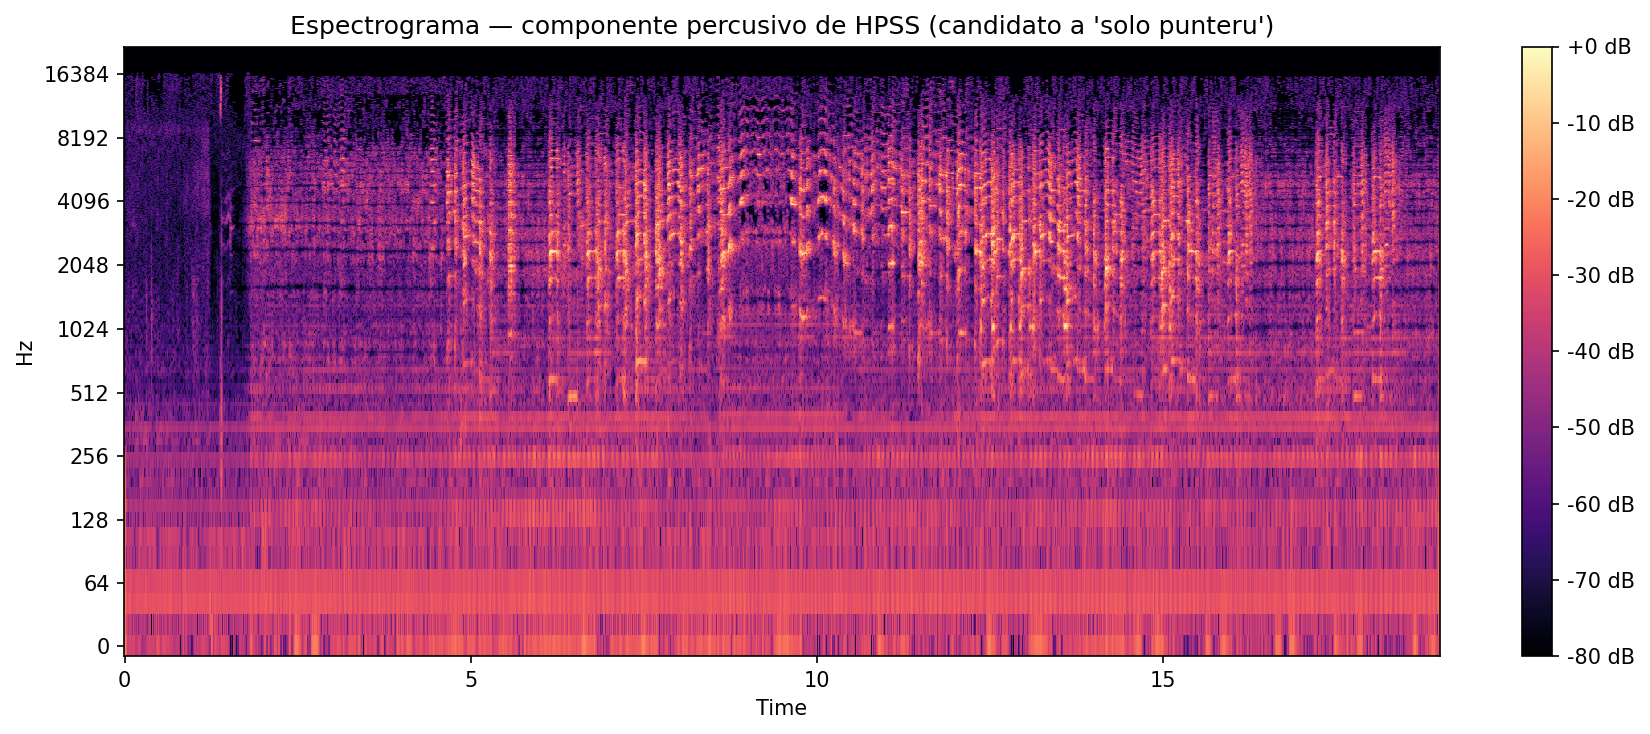
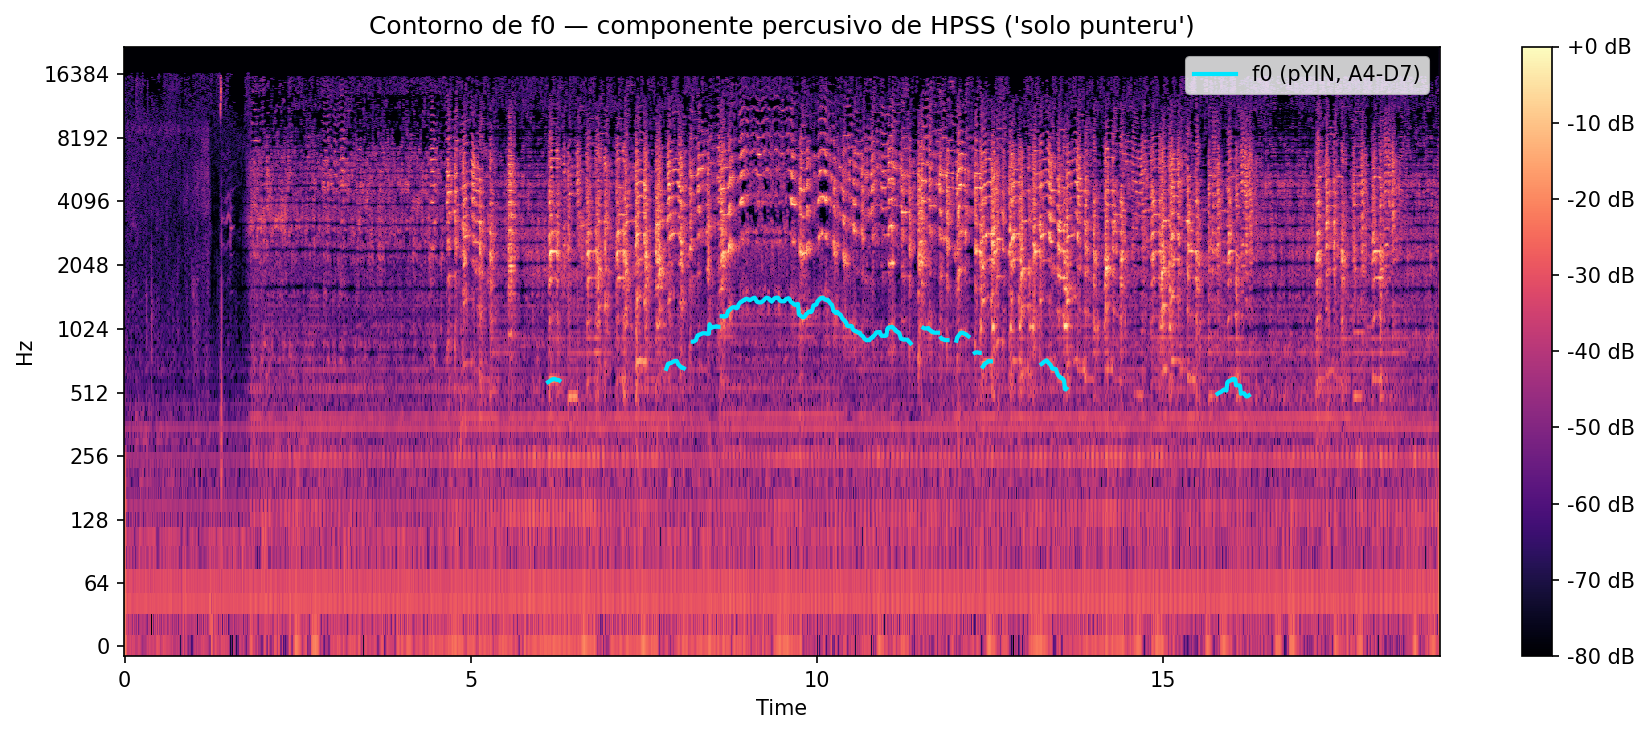
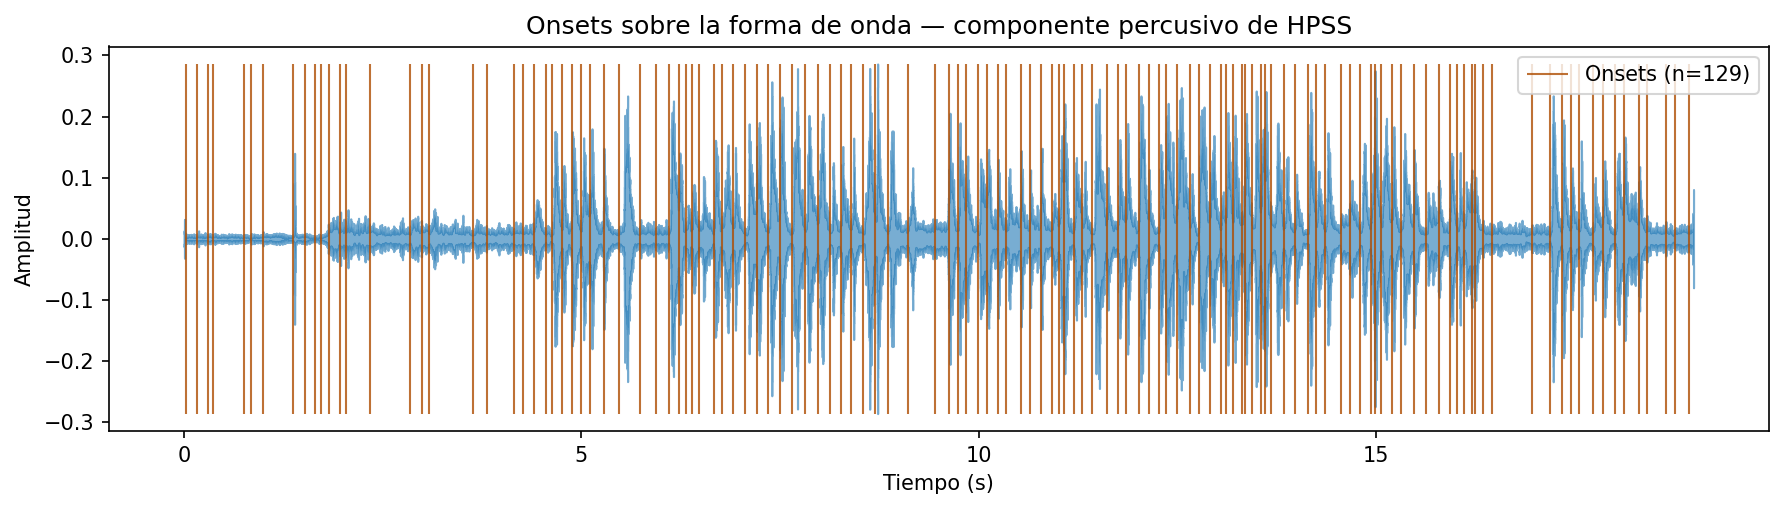
Avec le plateau « d’attaque » du HPSS — le résultat qui, en théorie, devrait ressembler le plus à « la mélodie seule » — j’ai répété les deux analyses précédentes. Le suivi de hauteur s’effondre : de la détection d’une note dans 92,7 % des instants, on passe à seulement 26,7 % — pratiquement 1 instant sur 4, alors qu’avant on en détectait presque tous. C’est une perte énorme d’information utile. Les onsets, en revanche, bougent à peine : 129 contre les 127 du signal complet, une différence trop petite pour compter comme une amélioration réelle.
Le filtre coupe-bande — le bistouri chirurgical qui ne tranche que la note exacte du roncón — se comporte exactement comme on pourrait l’attendre d’une intervention bien plus précise et moins agressive : le suivi de hauteur reste pratiquement identique, à 92,7 %, la même valeur que pour le signal complet. Il change si peu parce qu’il ne supprime que la fréquence exacte du roncón, laissant intacts ses échos harmoniques — qui, malheureusement, tombent précisément dans la même plage de fréquences où se déplace la mélodie du punteru, donc ils n’aident pas beaucoup à la nettoyer non plus — et les onsets restent exactement identiques, à 127.
Conclusions
La question qui a motivé cette expérience était directe : ce prétraitement aide-t-il à mieux analyser la cornemuse asturienne ? La réponse vérifiée est non. Les attaques de note changent à peine (127 contre 129, pratiquement pareil) et le suivi de la mélodie se détériore énormément (de 92,7 % à 26,7 % d’instants avec note détectée). Le tamis du HPSS ne parvient pas à isoler le punteru : il ne sépare pas bien le roncón, et emporte au passage une bonne part de la mélodie elle-même.
Ce qu’on peut affirmer avec certitude : la difficulté d’analyser la cornemuse asturienne avec ces outils n’est pas qu’une question de « c’est un vieil enregistrement ». C’est quelque chose propre à l’instrument lui-même — un bourdon continu et une mélodie sonnant en même temps, tous deux soutenus, sans aucune frontière « brusque contre soutenu » qu’un tamis comme le HPSS puisse exploiter pour les différencier. Séparer efficacement les deux exigerait probablement une technique différente — mais je n’en ai testé aucune, et je préfère laisser cela comme une question ouverte plutôt que de promettre une solution que je n’ai pas vérifiée.
Toute l’analyse — spectrogrammes, HPSS, pYIN, onsets, les chiffres exacts de cet article — se trouve dans le notebook que j’ai exécuté pour l’écrire, avec les résultats déjà calculés. Téléchargez-le avec l’extrait audio lui-même et refaites l’expérience vous-même, note par note.
Notebook de l'analyse (Jupyter)
Python + librosa. Inclut le calcul des chiffres de cet article et les figures déjà exécutées.
Références
- McFee, B., Raffel, C., Liang, D., Ellis, D. P. W., McVicar, M., Battenberg, E., & Nieto, O. (2015). librosa: Audio and Music Signal Analysis in Python. Proceedings of the 14th Python in Science Conference, 18–24.
- Documentation officielle de librosa — origine de
onset_detect,pyineteffects.hpss, utilisés dans cette analyse. - Mauch, M., & Dixon, S. (2014). pYIN: A fundamental frequency estimator using probabilistic threshold distributions. 2014 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 659–663.
- Archivo Sonoro de Celso Peyroux, Oviedo — cassette n°1, avril 1976, interprète Juan Huerta (La Torre, Teverga). Source primaire de l’enregistrement analysé.
- Photographie d’en-tête : archives familiales de Juan Huerta, prêtées pour la recherche de Tever Díaz García sur les musiciens populaires de Proaza et Teverga.
- Tous les chiffres de cet article ont été reproduits de façon indépendante en exécutant le notebook deux fois, avec des résultats identiques.