Ensayo · Laboratorio DIY
¿Se puede separar el roncón de la gaita en una grabación de campo?
Le pasamos a un algoritmo una grabación de hace casi 50 años de un gaitero real de Teverga e intentamos separar el roncón de la melodía antes de analizarla. La técnica estándar para esto, HPSS, es la que usamos en este pequeño experimento — y te contamos el resultado.
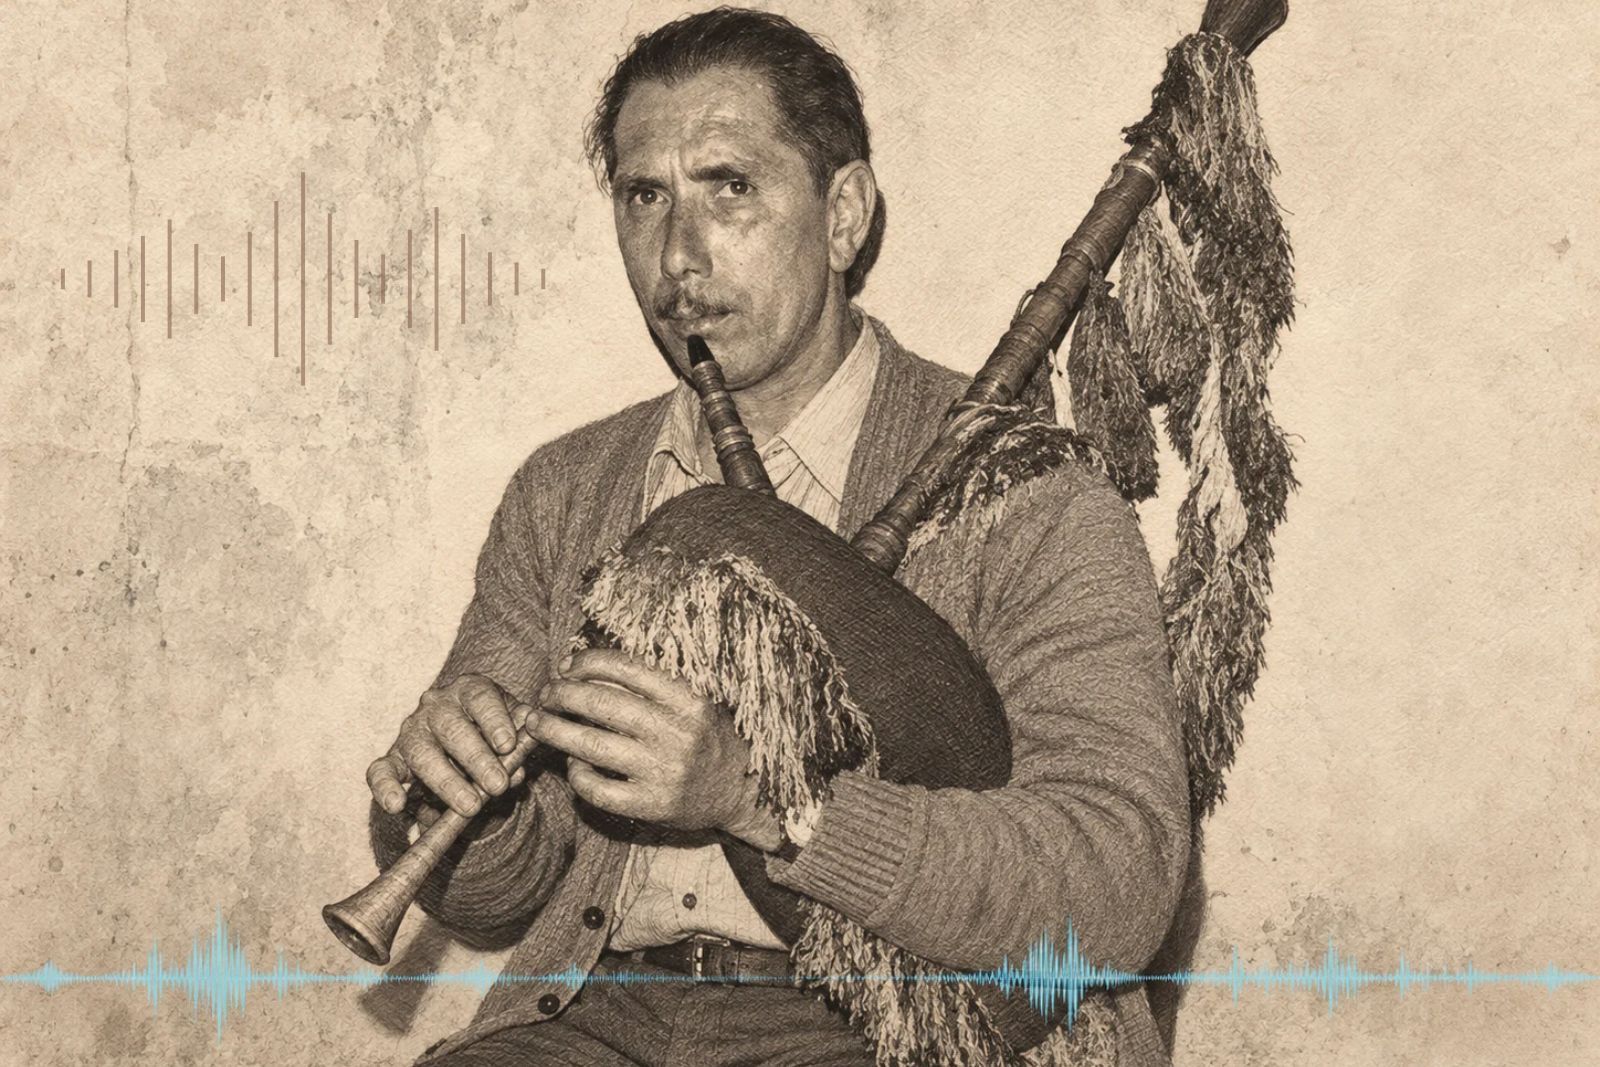
En abril de 1976, Celso Peyroux grabó en casete a Juan Huerta, gaitero de La Torre (Teverga), tocando la gaita asturiana. La cinta está hoy en el Archivo Sonoro del propio Celso, y la ficha del catálogo lo describe así: “uno de los grandes gaiteros que tuvo Teverga junto a Julio de Fresnedo y Floro Regina. Tocaban pa bailar a lo agarrao.” Casi cincuenta años después, le pasé un fragmento de esa grabación a un algoritmo para intentar responder una pregunta muy concreta: ¿puede un programa separar, automáticamente, el roncón (el bordón continuo) de la melodía del punteru, las dos voces que suenan a la vez en una gaita? Y si lo consigue, ¿ayuda eso a entender mejor la música?
La herramienta que uso para esto se llama Music Information Retrieval (MIR): la rama de la informática que enseña a un ordenador a “escuchar” audio y extraer información de él —cuándo empieza cada nota, qué altura tiene, qué tan fuerte suena—. No es magia ni inteligencia artificial en el sentido de “entiende la música”: son algoritmos que miden patrones en la onda de sonido.
Este experimento no es un retrato musical de Juan Huerta ni una pieza de etnomusicología — esa mirada humana a su figura la cuento en tever.es, en Gaiteros de la Tradición #4. Aquí me quedo en el terreno técnico, pero contado para quien no ha tocado un espectrograma en su vida.
Por qué el roncón es el problema de fondo
Cuando suena una gaita asturiana, en realidad estás oyendo dos instrumentos mezclados en un único sonido, sin forma de separarlos a simple oído: el roncón (o bordón), un tubo que produce una única nota fija y continua durante toda la pieza —como un zumbido grave de fondo que no para nunca—, y el punteru, el tubo con agujeros que toca la melodía por encima. Piensa en el roncón como el bajo de un grupo de música que nunca deja de tocar la misma nota: ni siquiera hay un silencio breve en el que “se le pueda oír solo” para aprender cómo suena aislado. Está siempre ahí, mezclado, todo el rato.
Eso es un problema para cualquier algoritmo. Si quieres que un programa analice solo la melodía —solo el punteru—, primero tendría que quitar de en medio ese zumbido constante del roncón. Y como nunca hay un hueco de silencio del que aprender “esto es solo ruido de fondo”, el algoritmo lo tiene difícil desde el principio.
Este artículo cuenta el experimento en cinco pasos:
- Reviso qué tan buena es la grabación en sí.
- Localizo el roncón dentro del sonido.
- Analizo la pieza completa tal cual llega.
- Intento separar el roncón de la melodía.
- Comparo si esa separación mejoró algo o no.
Antes de entrar en el detalle técnico, esto es lo que se analiza: 19 segundos de esa cinta de 1976, tal cual suena, sin limpiar. En concreto, es el floréu d’entamu —el floreo de entrada— de un entemediu de misa: una pieza breve que se toca en los momentos de descanso de la misa.
Qué calidad tiene la grabación
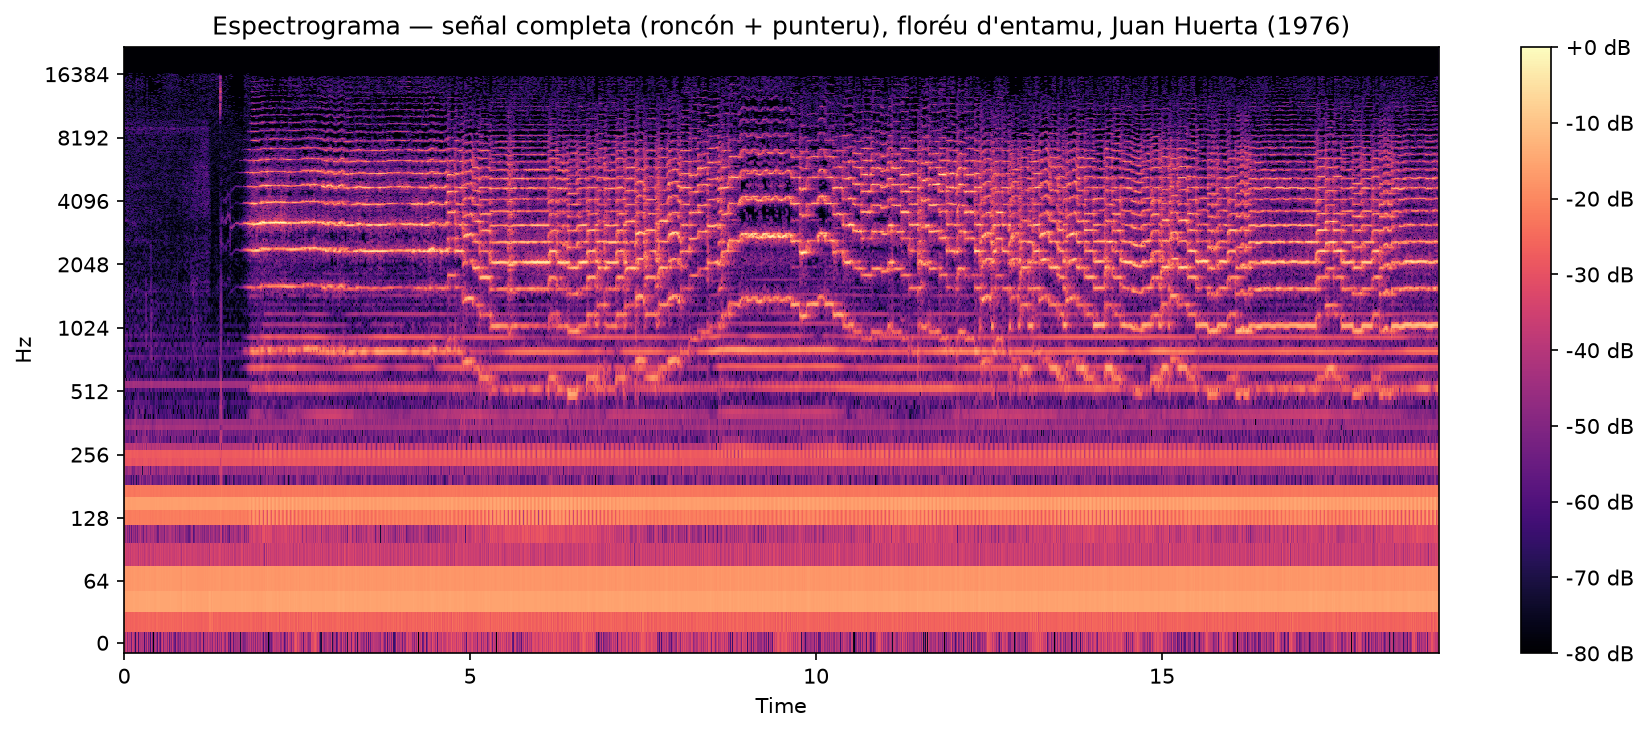
Es una cinta de campo grabada en casete en 1976, no una toma de estudio, y eso se nota en el propio audio de forma medible. Para verlo uso un espectrograma: una imagen que muestra qué frecuencias (graves, agudos) suenan en cada instante, como una especie de “radiografía” del sonido a lo largo del tiempo. En esa imagen aparece un ruido de fondo muy típico de aparatos eléctricos antiguos —el zumbido de la corriente— en 49.80 Hz, con un eco más agudo en 150.7 Hz que es casi exactamente el triple de esa frecuencia (150.7 dividido entre 49.80 da 3.03, prácticamente 3). Eso encaja con ruido eléctrico de la red, no con nada musical: ambos tonos suenan con una estabilidad casi perfecta —apenas varían nada de un instante a otro—, y esa quietud absoluta es justo la firma de un zumbido de fondo, no de una nota tocada por una persona.
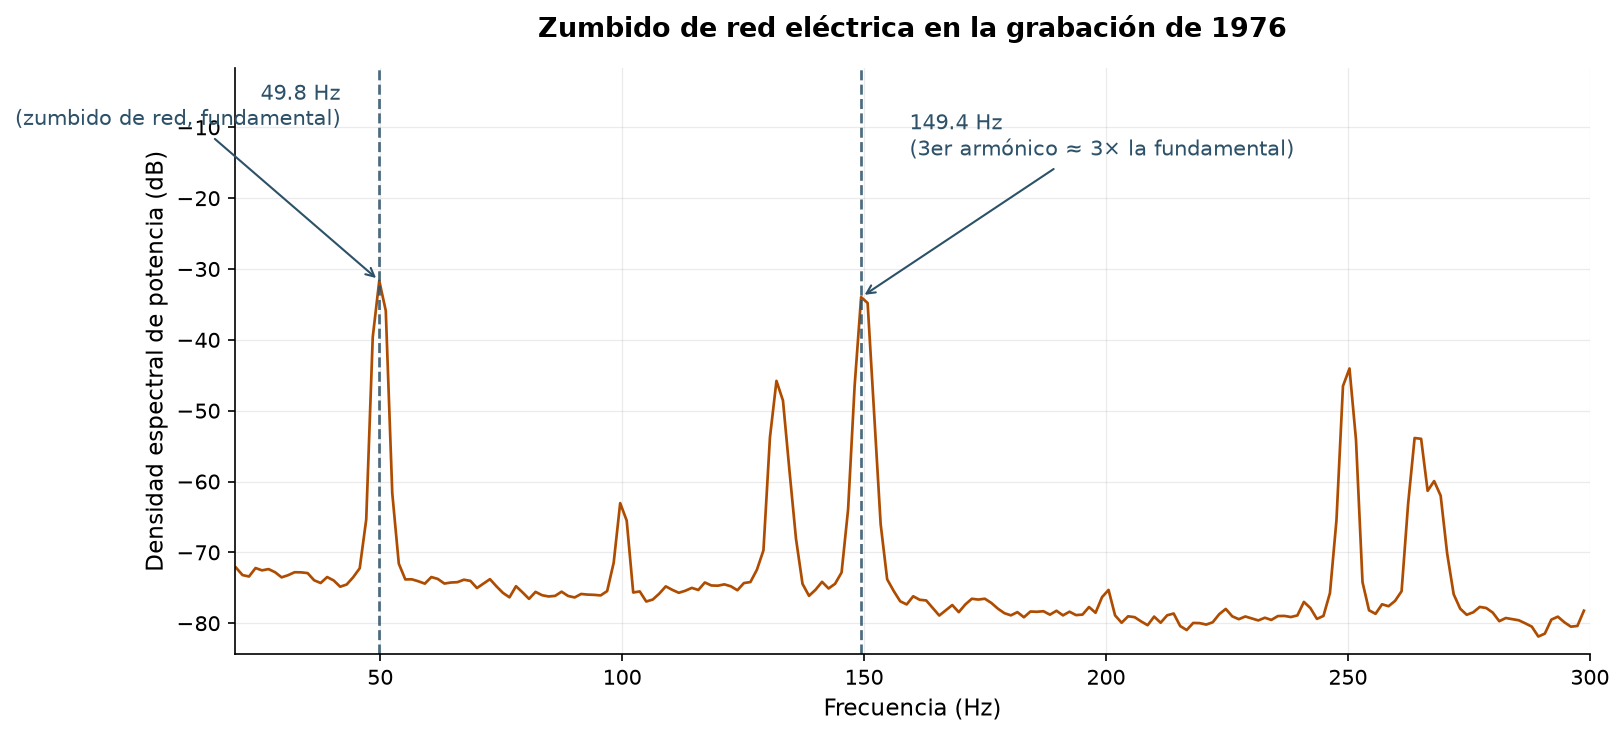
Los dos picos del zumbido de red eléctrica, casi tres veces más agudo uno que el otro: la firma inconfundible de un aparato antiguo, no de nada musical.
Sobre lo fuerte o floja que suena la grabación: mido esto con RMS, una forma estándar de calcular “qué tan fuerte suena de media” una señal (a diferencia del pico más alto puntual, el RMS resume el volumen sostenido). En decibelios (dB, la unidad con la que medimos volumen: cuantos más dB, más fuerte) esa media fluctúa 15.2 dB entre los momentos más flojos y los más fuertes de la pieza completa. Aquí hace falta una aclaración honesta: en una grabación de gaita asturiana no hay ningún momento de silencio real que medir, porque el roncón suena todo el rato — así que no puedo comparar “señal contra silencio” para calcular qué tan limpia está la grabación, como sí podría hacer con una voz o un piano, que sí callan entre frases. Por eso mido en su lugar cuánto sube y baja el volumen de la mezcla completa: es la métrica que sí tiene sentido cuando el “fondo” nunca deja de sonar.
Dónde vive el roncón dentro del sonido
Antes de intentar separarlo, necesitaba confirmar exactamente en qué frecuencia vive el roncón. Para no confundirlo con el zumbido de red del apartado anterior —una trampa real, porque sus armónicos caen cerca de la banda del roncón—, relocalicé ese zumbido con precisión (49.80 Hz) y dividí el fragmento en 18 ventanas de un segundo, mirando en cada una cuál era la frecuencia más fuerte y descartando cualquier candidato demasiado próximo a los armónicos del zumbido. La fundamental real del roncón es la frecuencia que más veces se repite como ganadora entre esas 18 ventanas.
El resultado: 132.0 Hz, nota C3, con 12 de las 18 ventanas votando por ese valor como fundamental — un resultado dominante y consistente. Para medir cuánto se aleja esa afinación de la “oficial”, los músicos usan los cents: cada semitono se divide en 100 partes iguales, así que una nota a +15.6 cents está apenas a una sexta parte de semitono por encima de lo estándar —una diferencia tan pequeña que casi ningún oído la nota—. Respecto al C3 estándar de una afinación en A440, son +15.6 cents: prácticamente afinación estándar, ligeramente alta. Esa frecuencia aparece de forma prominente en el 55.4% de las ventanas analizadas. Por encima de la fundamental, el roncón también genera armónicos: ecos más agudos a múltiplos exactos de la frecuencia base. Esos armónicos varían más en intensidad porque se mezclan acústicamente con la melodía del punteru que suena por encima — solo la nota fundamental del roncón se mantiene con esa estabilidad característica de un bordón.
Que el roncón suene en Do no es casualidad ni una elección libre del instrumento: es el acompañamiento armónico que lleva la gaita cuando toca sola o solo con tambor, y por eso su nota es siempre la tónica del punteru —la nota de reposo, sobre la que resuelve la melodía— pero dos octavas por debajo del Do grave (C5) que toca el propio punteru. Medir 132 Hz y comprobar que es C3 no es solo un dato de afinación: es la confirmación de que esta gaita está, en efecto, afinada en Do.
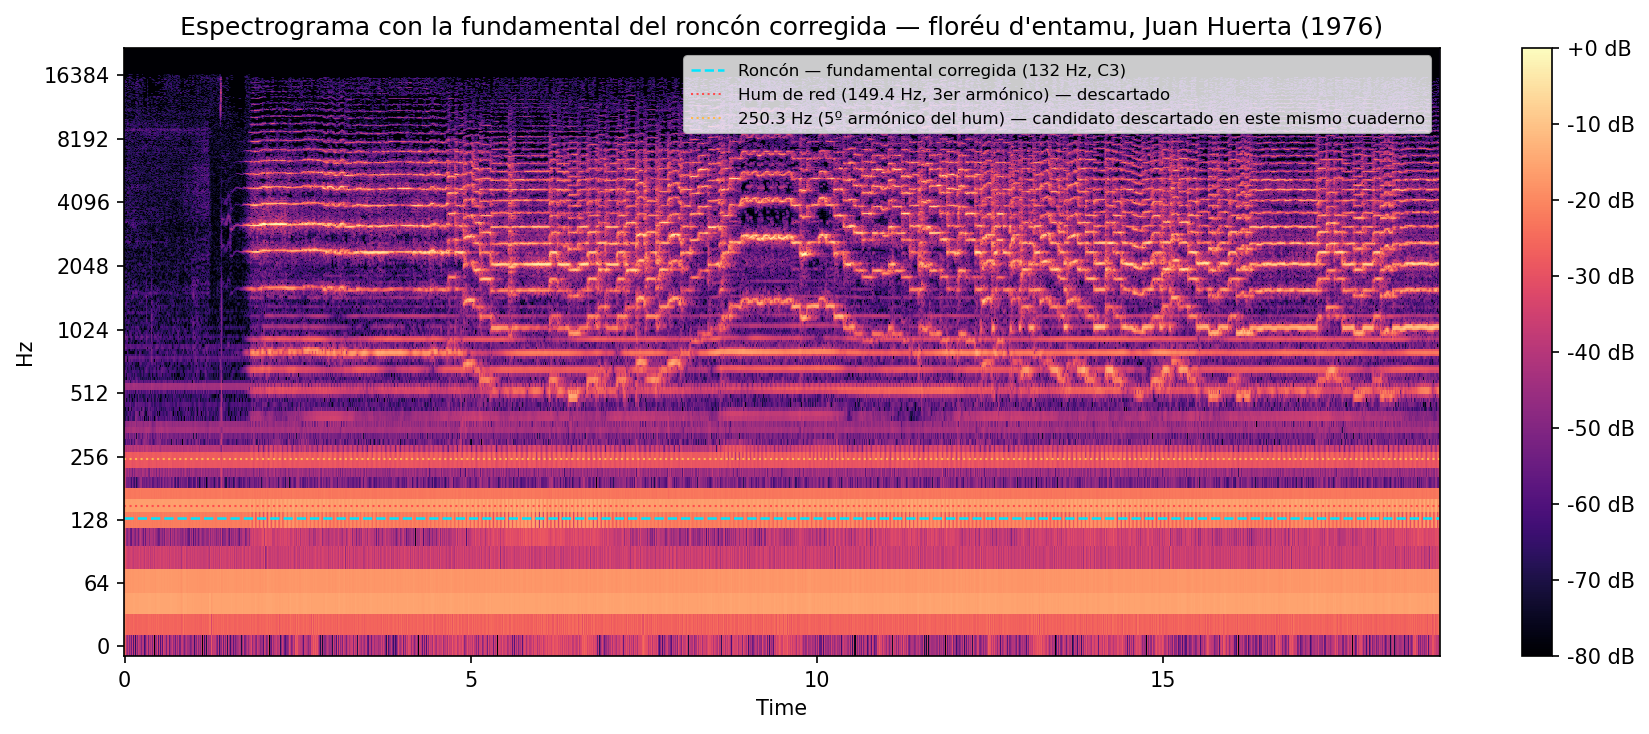
El roncón marcado sobre el espectrograma: su nota principal, en 132.0 Hz (C3), se mantiene como una banda horizontal constante durante toda la pieza — marcados también los candidatos descartados por ser fuga espectral del zumbido de red.
La pieza tal cual: roncón y melodía mezclados
Antes de tocar nada del audio, analicé la grabación completa tal como llegó, con dos herramientas distintas.
La primera busca onsets: el instante exacto en que empieza cada nota, el “ataque” del sonido. Es lo primero que necesita cualquier sistema que quiera transcribir una pieza a partitura: saber cuándo pasa algo. Sobre los 19 segundos de esta grabación, el algoritmo detecta 127 onsets — casi 7 notas nuevas por segundo, un ritmo denso, típico de la gaita asturiana.
La segunda tarea es el seguimiento de altura (pitch-tracking): averiguar, instante a instante, qué nota exacta se está tocando. Uso para esto un método llamado pYIN: un algoritmo que, en cada fracción de segundo, calcula la frecuencia más probable que está sonando y con cuánta confianza lo afirma —no adivina, mide—, limitado al rango de notas real que puede tocar un punteru de gaita asturiana. El resultado: consigue detectar una altura clara en el 92.7% de los instantes analizados — prácticamente en todo el fragmento, solo falla en 1 de cada 13 instantes aproximadamente.
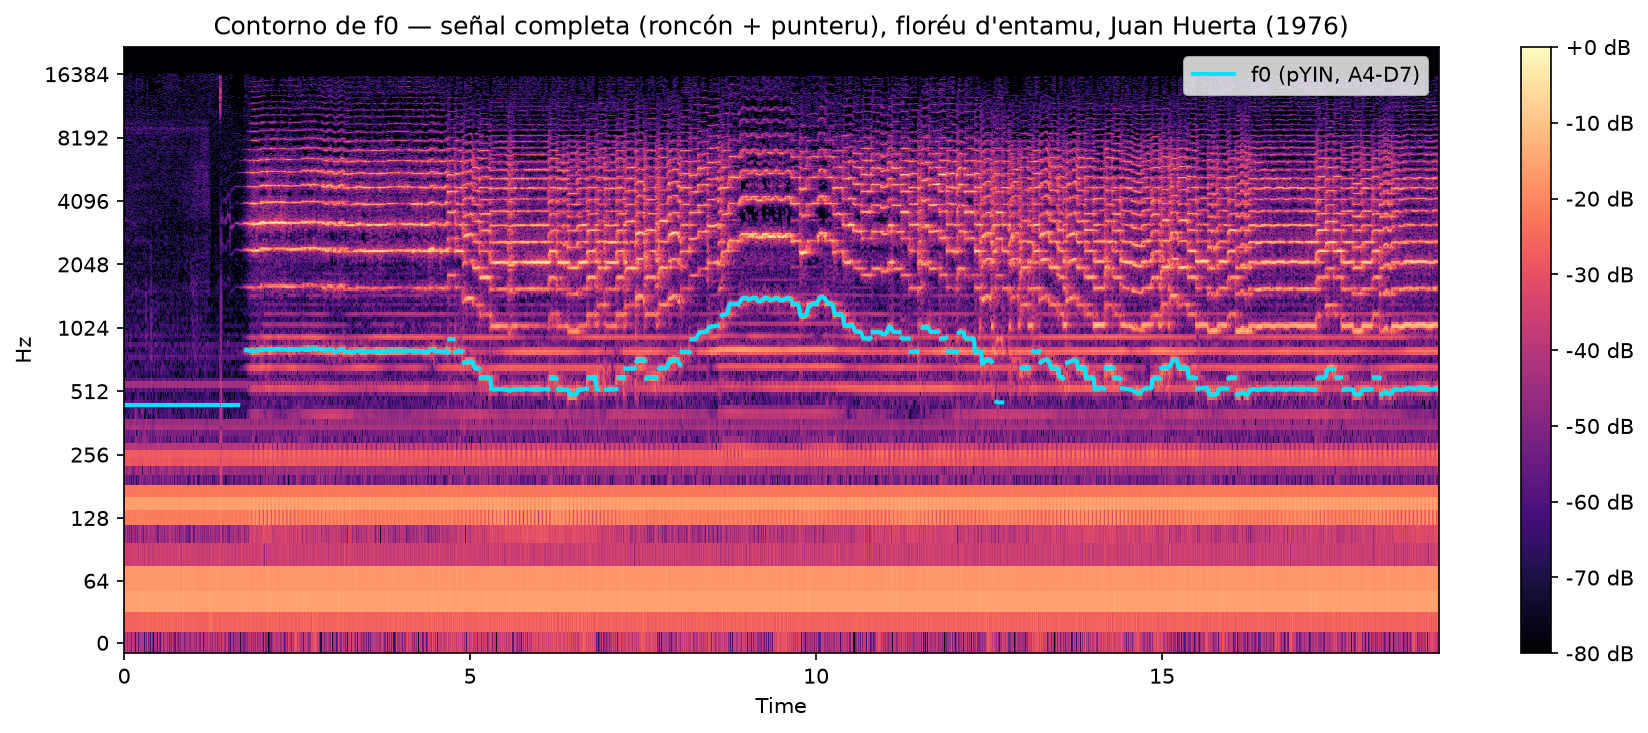
¿Qué tiene que ver esa línea con la pieza real? En mis clases enseño el floréu d’entamu con un esquema de tres partes —inicio, cuerpo y remate—, cada una con sus notas de referencia:
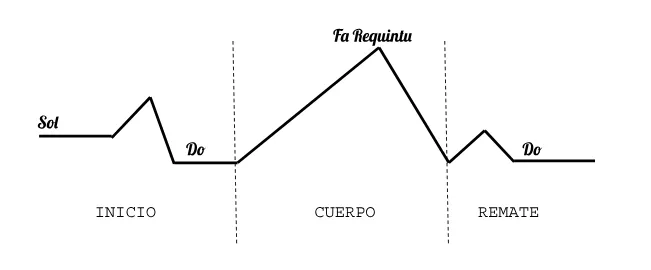
Contrastando la línea de f0 contra este esquema, lo que el algoritmo detecta encaja con las tres partes, aunque en el inicio la forma real es más contenida que la del esquema “de libro”:
- El pico del cuerpo coincide con precisión. La frecuencia más aguda de todo el fragmento —1437.8 Hz, nota F6— aparece en el segundo 10.08, justo en mitad del cuerpo. Es exactamente la nota que el esquema marca como clímax: el Fa Requintu.
- El remate también encaja. En los últimos tres segundos, Do (C5) es, con diferencia, la nota que más aparece: 167 de unos 238 instantes analizados. El esquema cierra la pieza en Do, y eso es justo lo que mide el algoritmo.
- El inicio encaja, pero con una subida más corta que la del esquema. La línea real sube a A4 (La) —no a un Do agudo, como harían floreos más expansivos, al estilo de José Remis Ovalle (uno de los maestros que creó escuela en Asturias, con una forma de florear tan reconocible que muchos gaiteros la imitaron)— y desde ahí baja ya hasta asentarse en Do (C5) a partir del segundo 5.3. Es la misma forma de fondo que dibuja el esquema —subir y volver a Do—, pero con un salto más corto: un recurso de estilo propio, no un fallo del esquema ni del algoritmo.
Ese matiz en el inicio es, de hecho, la parte más interesante del contraste: el esquema da la forma general de la frase —dónde sube, dónde baja, dónde remata—, pero no fija la amplitud exacta de cada floreo, que varía según quién toque y cómo. Comparar el análisis automático contra la forma “de libro” de una pieza es una manera real de ver, nota a nota, cómo una interpretación concreta se mueve dentro de esa forma.
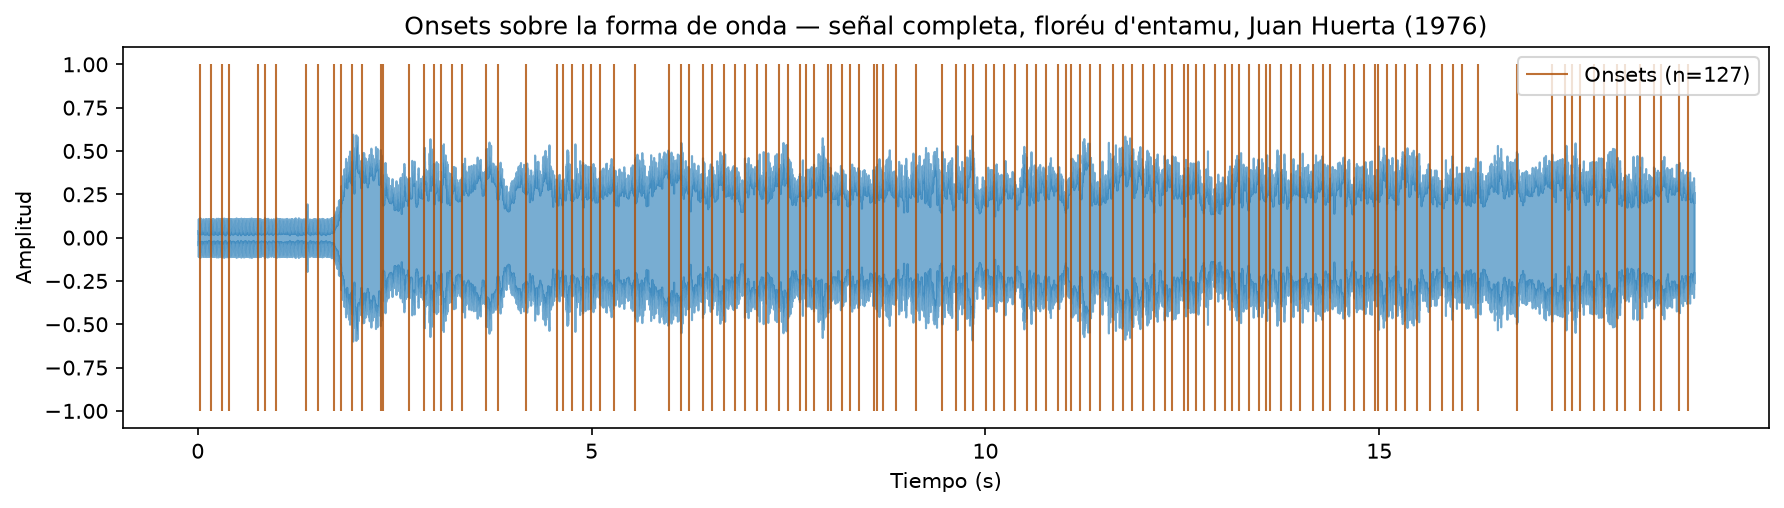
Estos tres resultados son la línea de partida: lo que da el análisis sin tocar nada del audio. La pregunta siguiente es si quitar el roncón antes de analizar mejora esto.
¿Se puede separar el roncón de la interpretación?
Para intentar quitar el roncón de en medio, probé la técnica estándar que se usa en estos casos: HPSS (Harmonic-Percussive Source Separation, separación armónico-percusiva). Imagínala como un cedazo —un colador con una malla que deja pasar unas cosas y retiene otras— que cuela el sonido en dos bandejas: en una caen los sonidos “de golpe” —percusivos, como un bombo o un chasquido, que empiezan de repente y se apagan rápido— y en la otra caen los sonidos “sostenidos” —armónicos, como una nota de piano o de violín mantenida en el tiempo—. El roncón es, por definición, un sonido sostenido puro: no ataca de golpe, suena siempre igual. La apuesta era razonable: si el cedazo separa bien lo sostenido de lo percusivo, el roncón debería caer entero en una de las dos bandejas, dejando la otra más limpia.
El resultado es que el cedazo no funciona aquí, y merece la pena explicar por qué. HPSS fue pensado para casos como separar un piano de una batería: ahí sí hay una frontera real entre “suena de golpe” y “suena sostenido”. Pero en la gaita asturiana, tanto el roncón como la melodía del punteru son sonidos sostenidos — ninguno de los dos es percusivo, ninguno “ataca de golpe” y se apaga. Para el cedazo, roncón y melodía son la misma clase de grano: los dos caen en la misma bandeja, sin que haya manera de diferenciarlos por esa vía.
Las cifras lo confirman. Midiendo otra vez con RMS —el mismo “cuánto suena de media” del apartado anterior—, la bandeja “sostenida” se queda con el 92.5% de la energía total del sonido — el roncón se va ahí casi entero, arrastrando consigo buena parte de la melodía. La bandeja “de golpe” apenas retiene el 19.0%. Y si miro específicamente cuánta energía del roncón queda en cada bandeja, la diferencia sigue siendo enorme: en la bandeja sostenida hay 77 veces más energía del roncón que en la bandeja percusiva — con la banda de frecuencia correcta (132 Hz, ya sin contaminación del zumbido de red), en lugar de la banda inflada de la versión anterior. A primera vista podría parecer una separación limpísima del roncón — pero no lo es: lo que de verdad pasó es que el cedazo empujó casi todo lo sostenido, roncón y melodía juntos, al mismo lado.
Como comparación más sencilla, probé también un filtro notch: en vez de un cedazo que clasifica, es un bisturí que corta quirúrgicamente una única frecuencia exacta —en este caso, los 132 Hz del roncón— y deja todo lo demás intacto. El resultado de esta comparación está en el siguiente apartado.
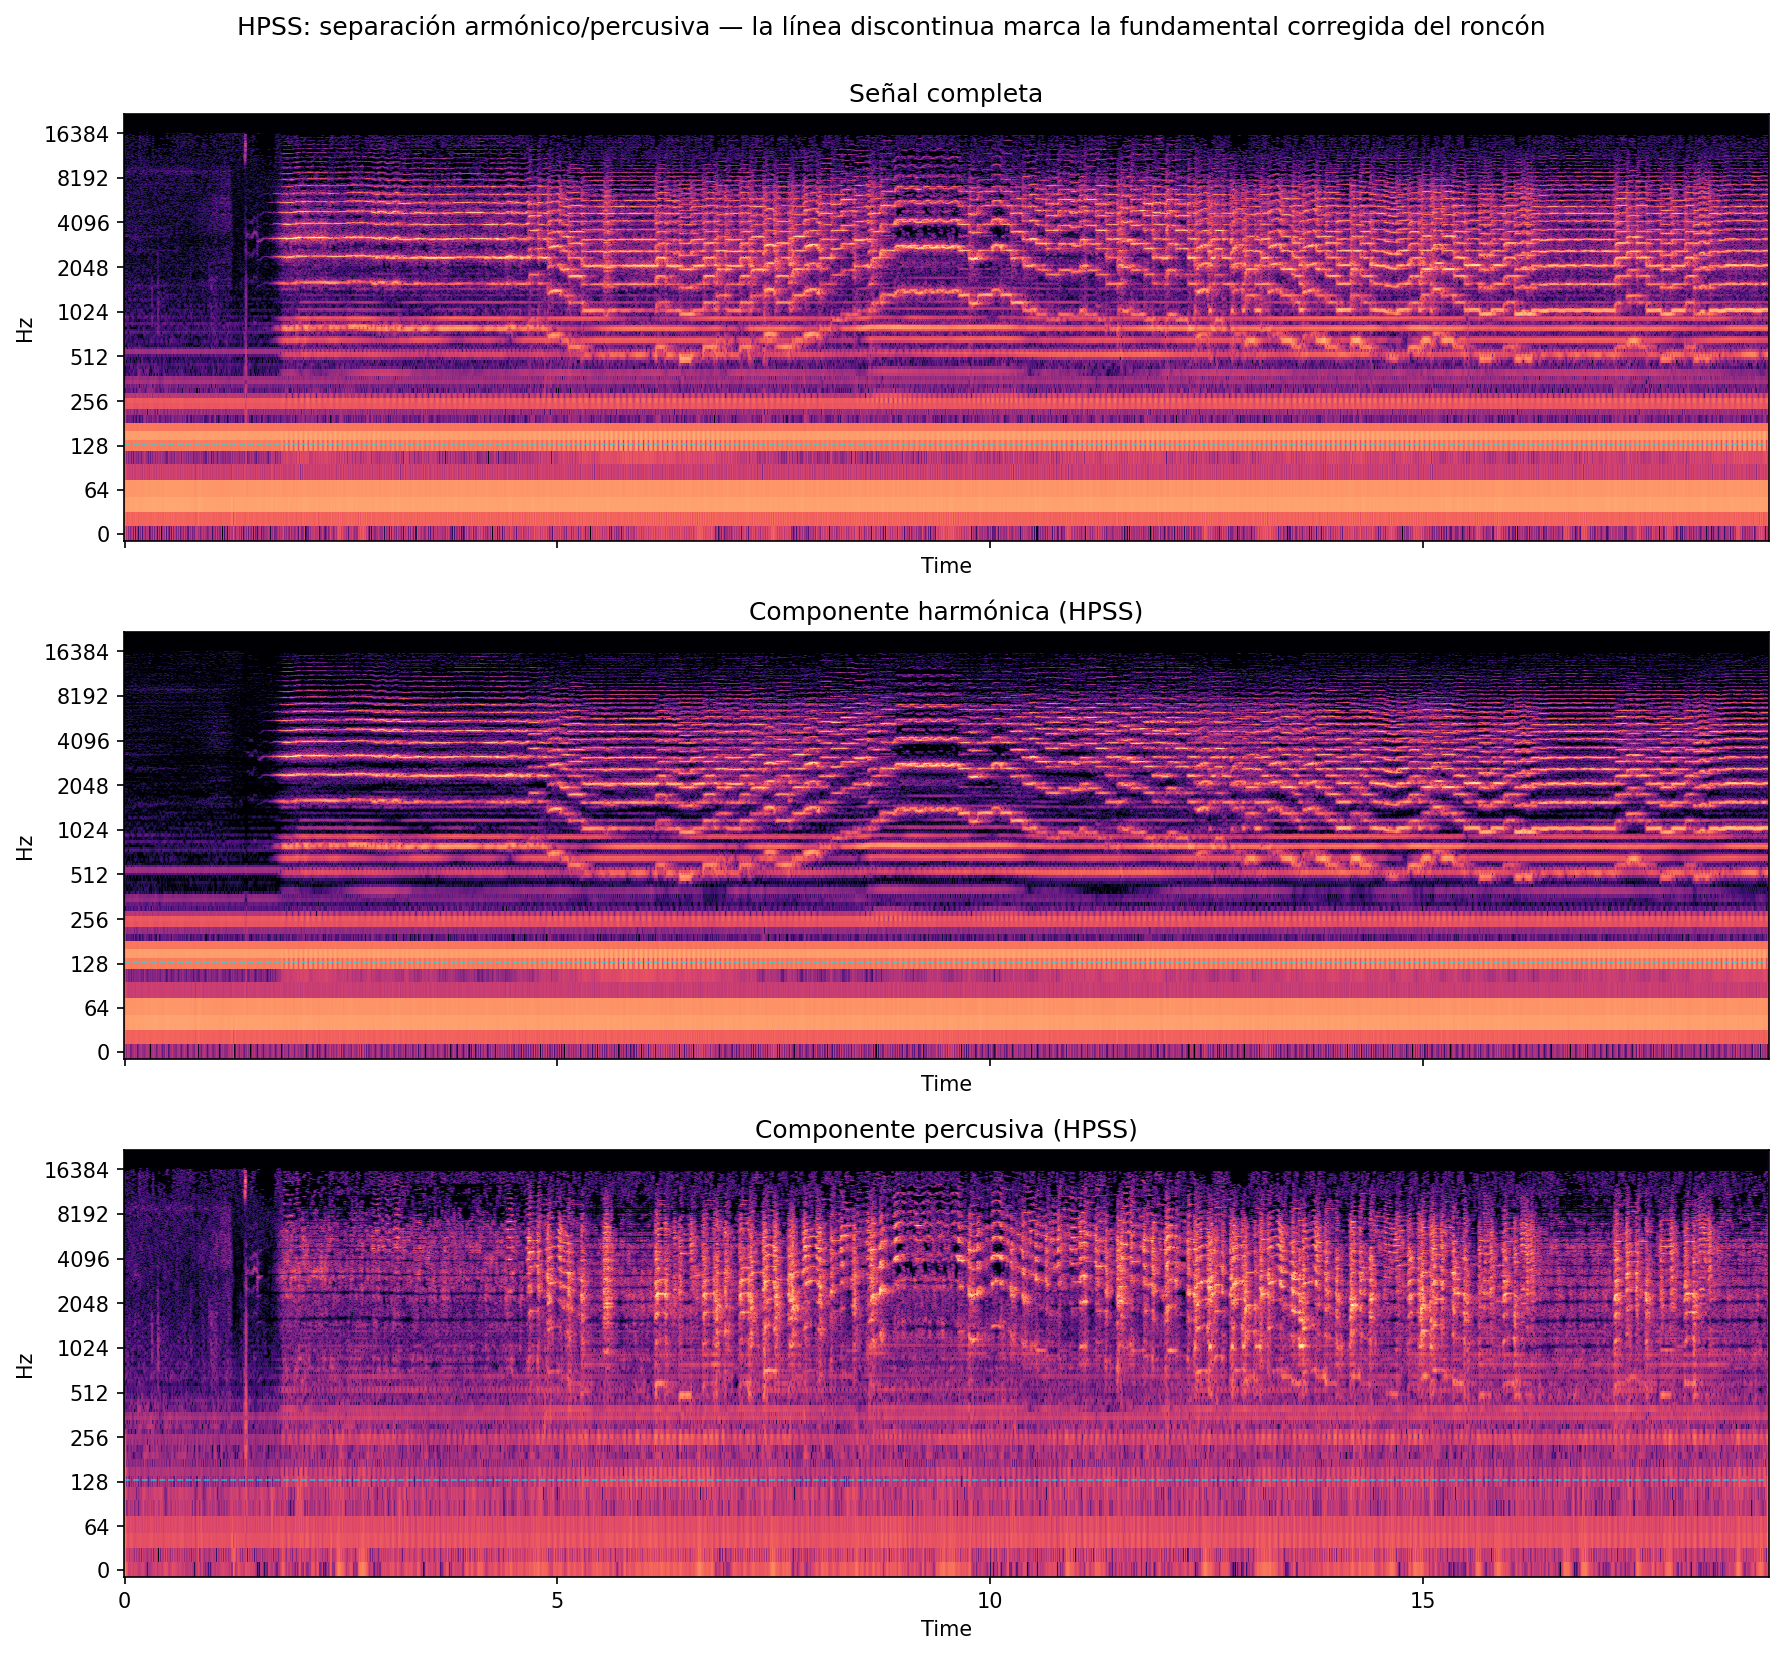
Comparativa HPSS: señal completa, bandeja “sostenida” (se queda con el 92.5% del sonido, incluido el roncón) y bandeja “de golpe” (solo el 19.0%).
Lo que este resultado dice en realidad
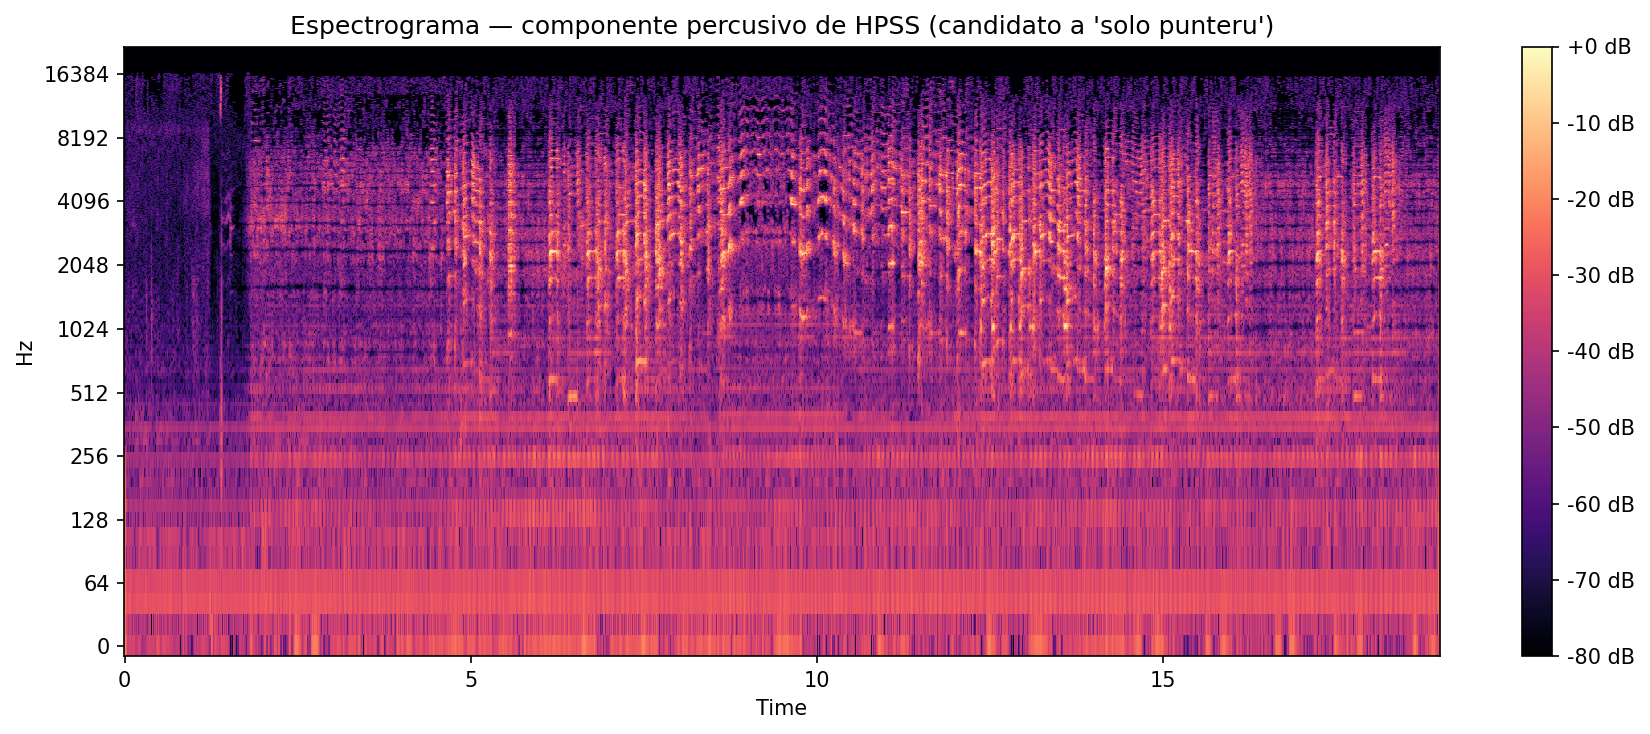
Esto no es solo “la técnica falló” — es un hallazgo sobre qué significa “separar el roncón” en este instrumento en concreto. El cedazo de HPSS no puede distinguir “roncón sostenido” de “nota del punteru sostenida”, porque ambos son, para él, exactamente el mismo tipo de sonido. El resultado del siguiente apartado —el seguimiento de altura empeora mucho, los onsets casi no cambian— confirma que separar por “sostenido frente a de golpe” es la herramienta equivocada para este caso, no que sea imposible separar roncón y melodía con cualquier técnica. Es un dato real y útil: explica con precisión por qué la gaita asturiana —un bordón continuo y una melodía, ambos sostenidos, sonando a la vez— es un caso genuinamente difícil para este tipo de análisis automático, más allá de “es una grabación vieja y con ruido”.
El análisis después de separar
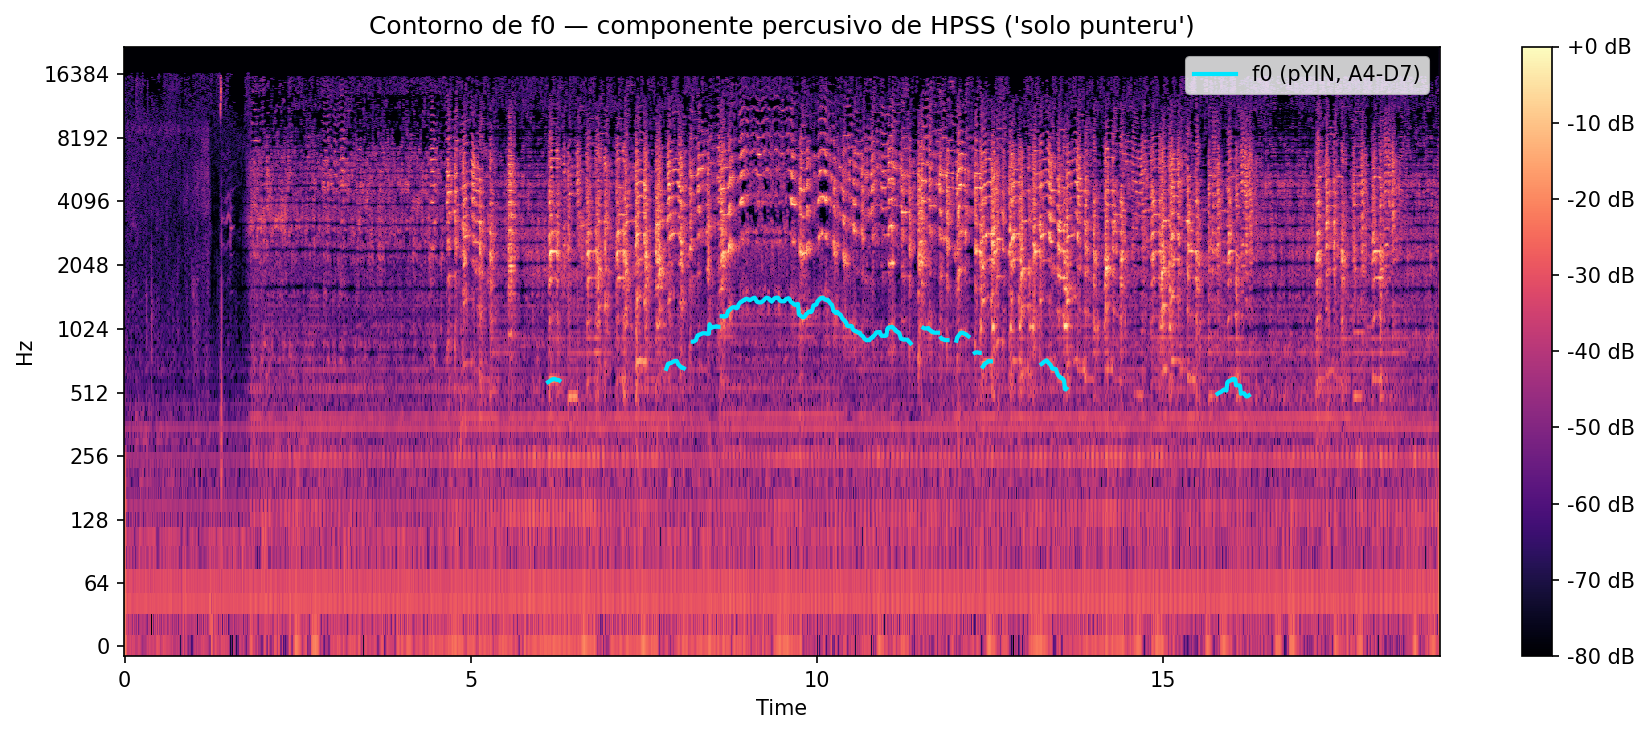
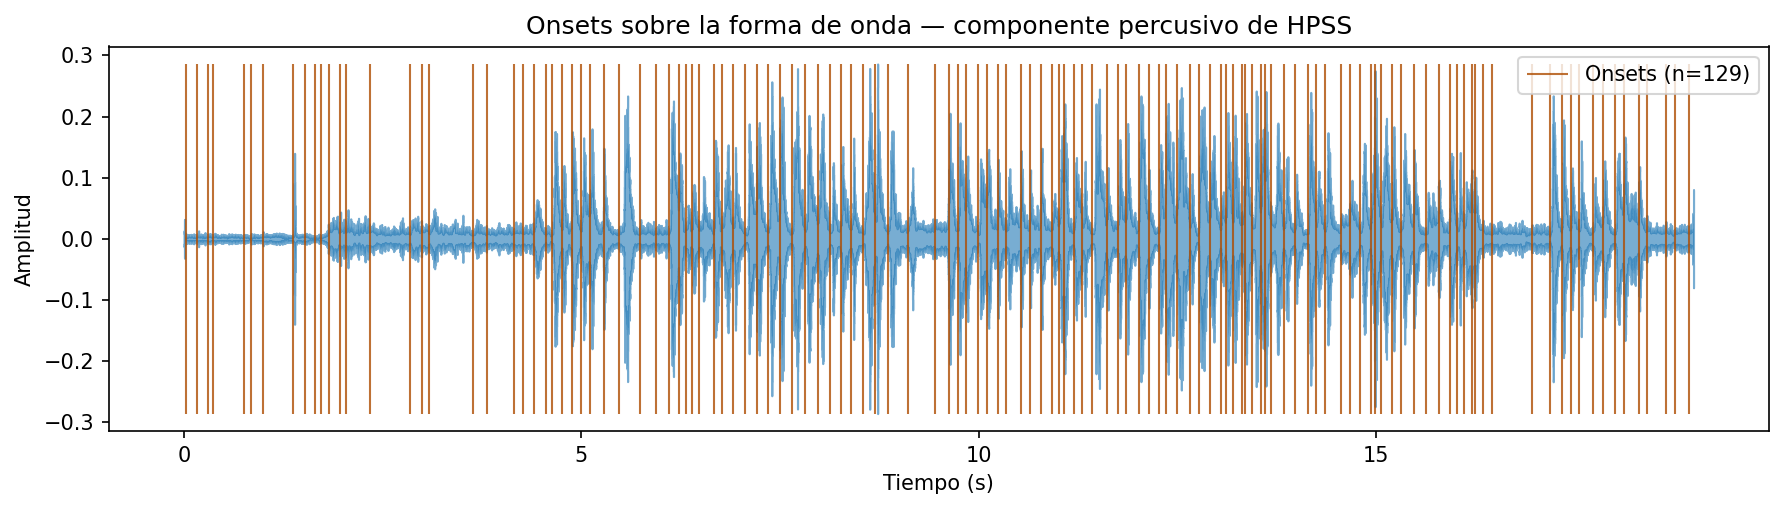
Con la bandeja “de golpe” de HPSS —el resultado que, en teoría, debería parecerse más a “solo la melodía”— repetí los dos análisis de antes. El seguimiento de altura se desploma: de detectar nota en el 92.7% de los instantes pasa a solo el 26.7% — prácticamente 1 de cada 4 instantes, cuando antes acertaba casi todos. Es una pérdida enorme de información útil. Los onsets, en cambio, apenas se mueven: 129 frente a los 127 de la señal completa, una diferencia tan pequeña que no cuenta como mejora real.
El filtro notch —el bisturí quirúrgico que solo corta la nota exacta del roncón— se comporta justo como cabría esperar de una intervención mucho más precisa y menos agresiva: el seguimiento de altura se queda prácticamente igual, en el 92.7%, el mismo valor que con la señal completa. Cambia tan poco porque solo elimina la frecuencia exacta del roncón, dejando intactos sus ecos armónicos — que, por desgracia, caen justo en el mismo rango de frecuencias donde se mueve la melodía del punteru, así que tampoco ayudan mucho a limpiarla — y los onsets se quedan exactamente igual, en 127.
Conclusiones
La pregunta que motivó este experimento era directa: ¿ayuda este preprocesado a analizar mejor la gaita asturiana? La respuesta verificada es no. Los ataques de nota casi no cambian (127 frente a 129, prácticamente lo mismo) y el seguimiento de la melodía empeora muchísimo (del 92.7% al 26.7% de instantes con nota detectada). El cedazo de HPSS no consigue aislar el punteru: no separa bien el roncón, y de paso se lleva por delante buena parte de la propia melodía.
Lo que sí se puede afirmar con esto: la dificultad de analizar la gaita asturiana con estas herramientas no es solo cuestión de “es una grabación vieja”. Es algo propio del instrumento — un bordón continuo y una melodía sonando a la vez, los dos sostenidos, sin ningún “de golpe frente a sostenido” que un cedazo como HPSS pueda usar para diferenciarlos. Separar ambos de forma efectiva exigiría, probablemente, una técnica distinta — pero no probé ninguna, y prefiero dejarlo como pregunta abierta en vez de prometer una solución que no he verificado.
Todo el análisis —espectrogramas, HPSS, pYIN, onsets, las cifras exactas de este artículo— está en el notebook que ejecuté para escribirlo, con los outputs ya calculados. Descárgalo junto con el propio fragmento de audio y repite el experimento tú mismo, nota por nota.
Notebook del análisis (Jupyter)
Python + librosa. Incluye el cálculo de las cifras de este artículo y las figuras ya ejecutadas.
Bibliografía
- McFee, B., Raffel, C., Liang, D., Ellis, D. P. W., McVicar, M., Battenberg, E., & Nieto, O. (2015). librosa: Audio and Music Signal Analysis in Python. Proceedings of the 14th Python in Science Conference, 18–24.
- Documentación oficial de librosa — origen de
onset_detect,pyinyeffects.hpss, usados en este análisis. - Mauch, M., & Dixon, S. (2014). pYIN: A fundamental frequency estimator using probabilistic threshold distributions. 2014 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 659–663.
- Archivo Sonoro de Celso Peyroux, Oviedo — casete n.º 1, abril de 1976, intérprete Juan Huerta (La Torre, Teverga). Fuente primaria de la grabación analizada.
- Fotografía de cabecera: archivo familiar de Juan Huerta, cedida para la investigación de Tever Díaz García sobre los músicos populares de Proaza y Teverga.
- Todas las cifras de este artículo se reprodujeron de forma independiente ejecutando el notebook dos veces, con resultados idénticos.